
译自 Anthropic 官方博客《Effective harnesses for long-running agents》,发布于 2025-11-26。
随着 AI 智能体的能力越来越强,开发者越来越希望它们承担需要数小时甚至数天才能完成的复杂任务。然而,如何让智能体在跨多个上下文窗口时保持稳定的进展,仍然是一个悬而未决的问题。
长时运行智能体(long-running agents)的核心挑战在于:它们必须在彼此隔离的会话中工作,而每一次新会话开始时,对之前发生的事都毫无记忆。不妨想象一个由轮班工程师组成的软件项目——每位新到的工程师都不记得上一个班次发生过什么。由于上下文窗口(context window)是有限的,而大多数复杂项目无法在单个窗口内完成,智能体需要一种方式来弥合各次编码会话之间的鸿沟。
我们开发了一套双管齐下的解决方案,让 Claude Agent SDK 能够在许多上下文窗口间高效工作:一个初始化智能体(initializer agent),在首次运行时搭建好环境;以及一个编码智能体(coding agent),其任务是在每次会话中取得渐进进展,同时为下一次会话留下清晰的工件。你可以在配套的 quickstart 中找到代码示例。
长时运行智能体的难题
Claude Agent SDK 是一个功能强大、用途广泛的智能体框架(agent harness),擅长编码,也擅长其他需要模型借助工具收集上下文、制定计划并加以执行的任务。它具备上下文压缩(compaction)等上下文管理能力,让智能体可以在不耗尽上下文窗口的情况下持续推进一项任务。理论上,有了这样的配置,智能体应该能够无限期地持续做有价值的工作。
然而,仅靠上下文压缩并不够。开箱即用时,即使像 Opus 4.5 这样的前沿编码模型,在 Claude Agent SDK 上跨多个上下文窗口循环运行,如果只给一个高层级的提示词——比如「做一个 claude.ai 的克隆版」——也无法构建出一个达到生产质量的 Web 应用。
Claude 的失败体现在两种模式上。第一种,智能体倾向于一次想做太多事情——本质上就是试图一次性完成(one-shot)整个应用。这常常导致模型在实现过程中耗尽上下文,留给下一个会话的是一堆实现了一半、毫无文档的功能。于是智能体不得不去猜测之前发生了什么,并花大量时间试图让基础应用重新跑起来。即使启用了上下文压缩也会发生这种情况,因为压缩并不总能向下一个智能体传递足够清晰的指令。
第二种失败模式往往出现在项目后期。在部分功能已经构建完成之后,后一个智能体实例会四处看看,发现已经有了进展,便宣布任务大功告成。
由此可以把问题拆解成两部分。第一,我们需要搭建一个初始环境,为某个提示词所要求的全部功能奠定基础,让智能体能够按步骤、按功能逐个推进。第二,我们应当提示每个智能体朝着目标取得渐进进展,同时在会话结束时把环境保持在干净状态。所谓「干净状态」,指的是适合合并到主分支的那类代码:没有重大缺陷,代码井然有序、文档完善,总体而言,开发者可以轻松开始一个新功能的开发,而不必先收拾一堆无关的烂摊子。
在内部实验中,我们用一套双部分的解决方案处理了这些问题:
- 初始化智能体:第一个智能体会话使用专门的提示词,要求模型搭建初始环境:一个
init.sh脚本、一个记录各智能体工作日志的 claude-progress.txt 文件,以及一个能体现新增了哪些文件的初始 git 提交。 - 编码智能体:之后的每个会话都要求模型取得渐进进展,然后在结束时留下结构化的更新。1
这里的关键洞见是找到一种方式,让智能体在拿到全新上下文窗口时能快速理解工作的当前状态——这通过 claude-progress.txt 文件配合 git 历史来实现。这些做法的灵感,来自对高效软件工程师日常工作的了解。
环境管理
在更新版的 Claude 4 提示指南中,我们分享了一些多上下文窗口工作流的最佳实践,其中包括一种框架结构:对第一个上下文窗口使用「不同的提示词」。这个「不同的提示词」要求初始化智能体把环境搭建好,为后续编码智能体高效工作准备好一切必要上下文。下面,我们对这类环境的一些关键组成部分做更深入的剖析。
功能清单
为了解决智能体一口气写完整个应用、或过早认定项目已完成的问题,我们提示初始化智能体撰写一份全面的功能需求文件,对用户的初始提示词进行扩展。以 claude.ai 克隆版为例,这意味着 200 多项功能,比如「用户可以打开一个新对话,输入查询,按下回车,然后看到 AI 的回复」。这些功能最初全部标记为「未通过(failing)」,这样后续的编码智能体就能清楚看到完整功能应当是什么样子。
{ "category": "functional", "description": "New chat button creates a fresh conversation", "steps": [ "Navigate to main interface", "Click the 'New Chat' button", "Verify a new conversation is created", "Check that chat area shows welcome state", "Verify conversation appears in sidebar" ], "passes": false }我们提示编码智能体只通过修改某个 passes 字段的状态来编辑这个文件,并使用措辞强硬的指令,比如「不允许删除或修改测试,因为这可能导致功能缺失或出现缺陷」。经过一番实验,我们最终选择用 JSON 来做这件事,因为与 Markdown 文件相比,模型更不容易不当地修改或覆盖 JSON 文件。
渐进进展
有了这套初始环境脚手架之后,下一版编码智能体就被要求一次只处理一个功能。事实证明,这种渐进式的方法对于纠正智能体「一次想做太多」的倾向至关重要。
在改为渐进式工作后,模型在完成代码改动后把环境保持在干净状态依然至关重要。实验中我们发现,激发这一行为的最好方式是要求模型用描述性的提交信息把进展提交到 git,并在进度文件中写下工作摘要。这让模型能够借助 git 回滚糟糕的代码改动,恢复代码库的正常工作状态。
这些做法还提高了效率,因为智能体不再需要猜测之前发生了什么,也不必把时间花在让基础应用重新跑起来上。
测试
我们观察到的最后一个主要失败模式,是 Claude 倾向于在未经恰当测试的情况下就把功能标记为完成。如果缺少明确的提示,Claude 往往会直接改动代码,甚至用单元测试或对开发服务器执行 curl 命令来做测试,却没能意识到该功能端到端地跑不通。
在构建 Web 应用时,一旦被明确提示去使用浏览器自动化工具、像人类用户那样做全部测试,Claude 在端到端验证功能方面大多做得不错。
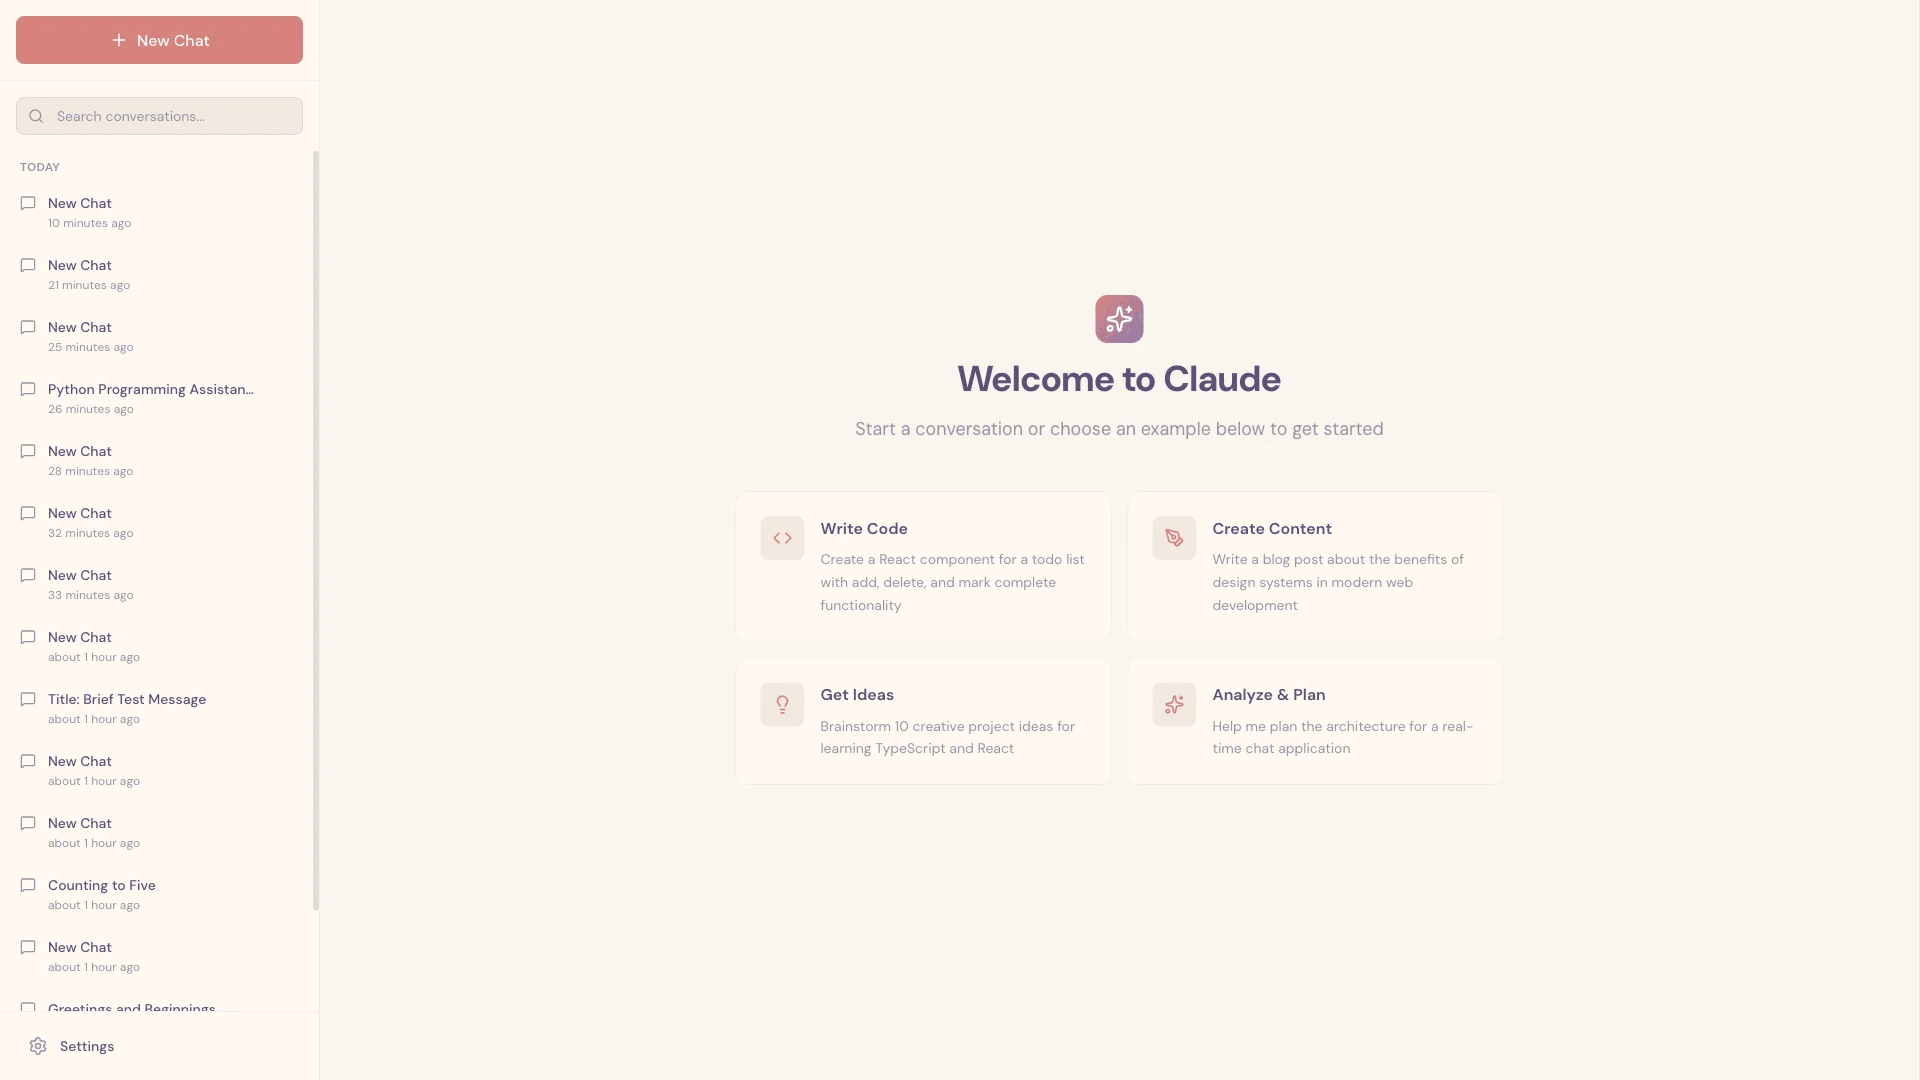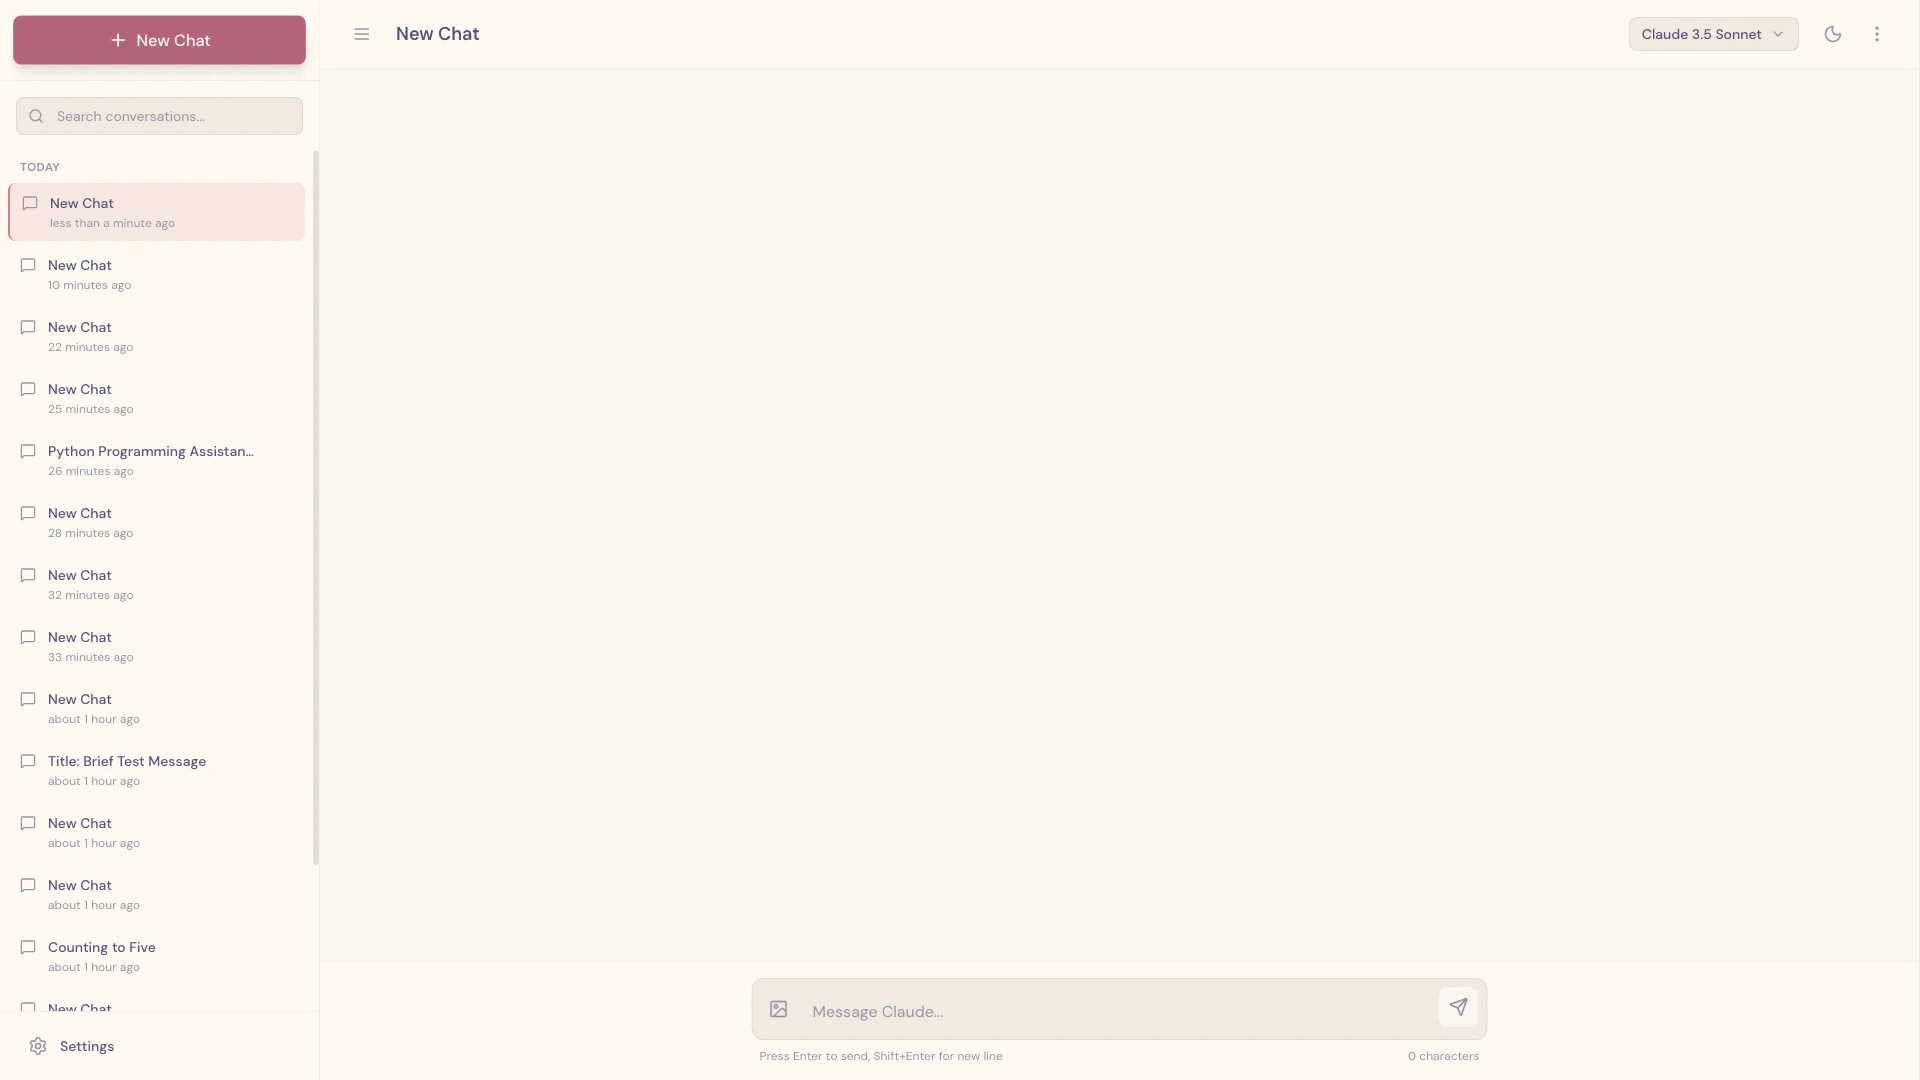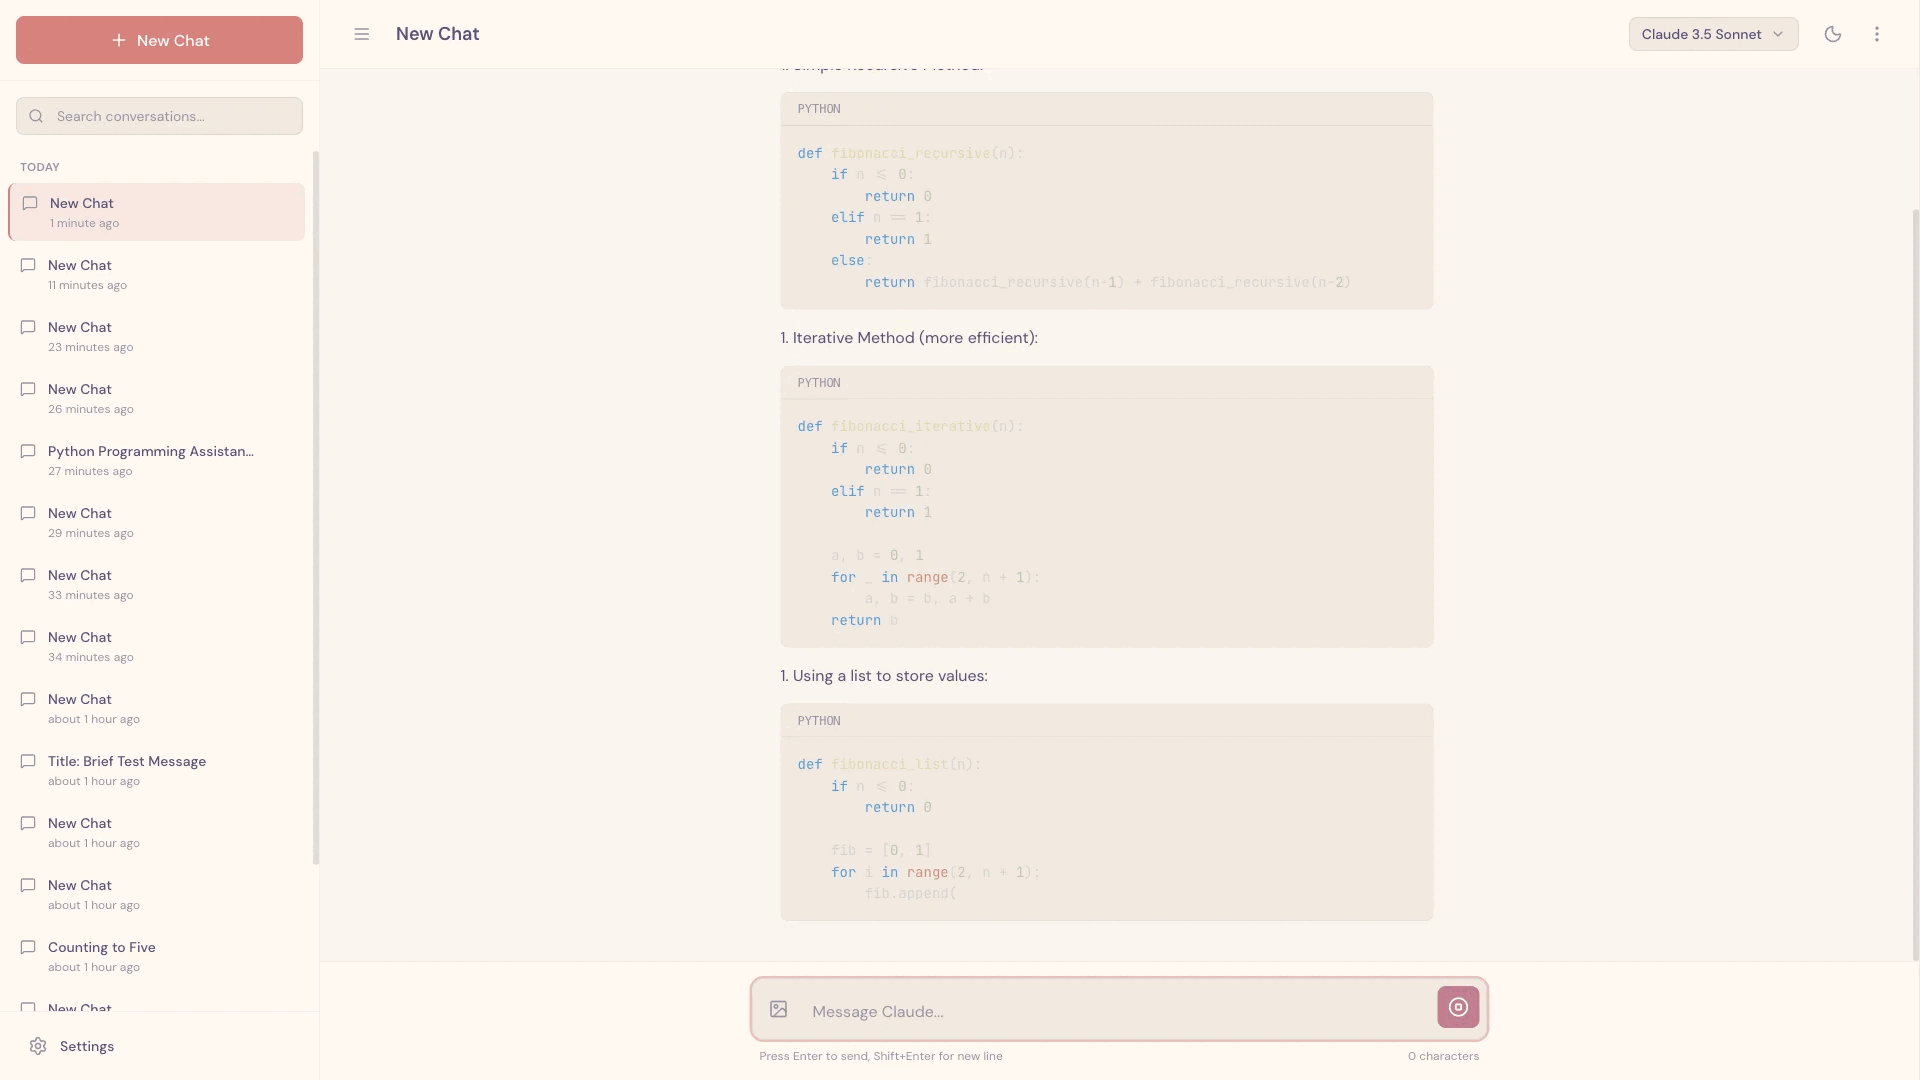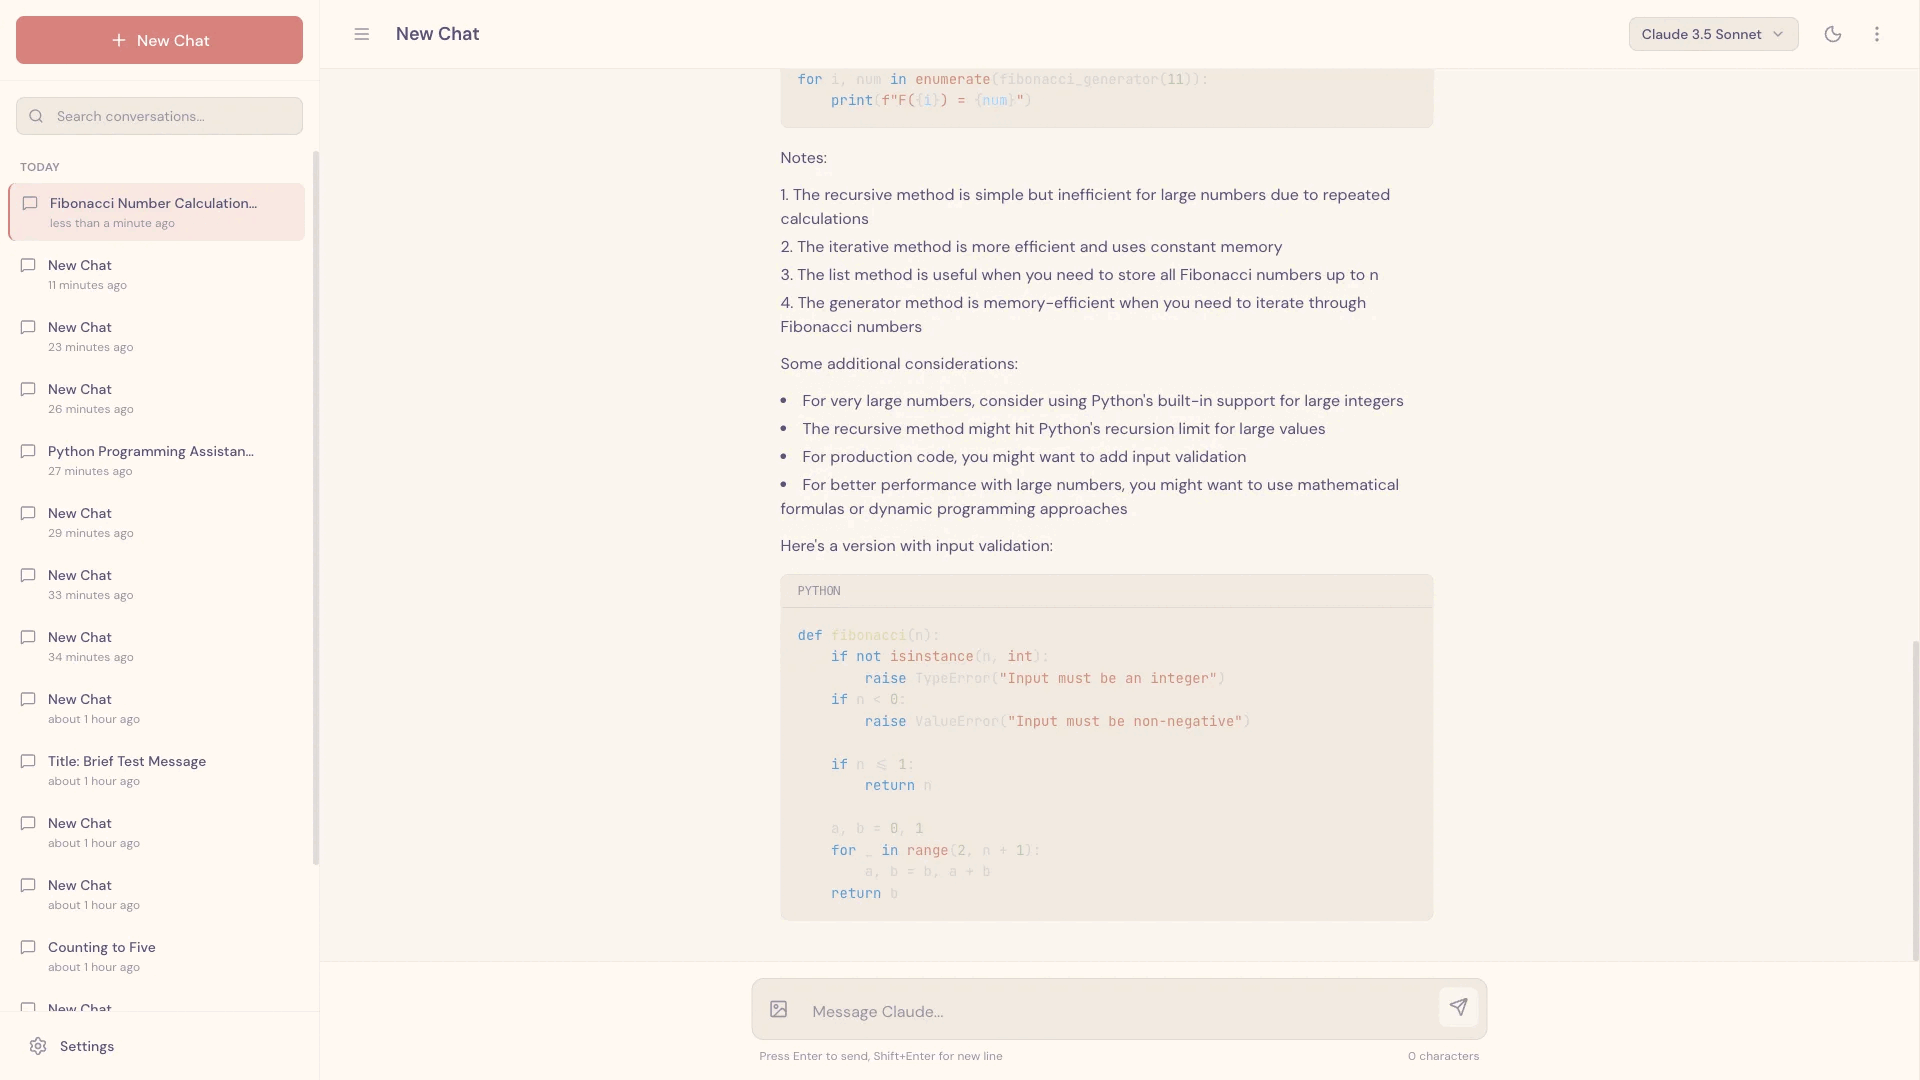
这些截图是 Claude 通过 Puppeteer MCP 服务器测试 claude.ai 克隆版时截取的。
为 Claude 提供这类测试工具显著提升了表现,因为智能体能够发现并修复那些仅凭代码看不出来的缺陷。
仍有一些遗留问题,比如 Claude 的视觉能力与浏览器自动化工具的限制,使它难以识别每一类缺陷。例如,Claude 无法通过 Puppeteer MCP 看到浏览器原生的 alert 弹窗,因此依赖这些弹窗的功能往往更容易出问题。
快速进入状态
有了上述所有机制,每个编码智能体都会被提示按一系列步骤来摸清现状——有些步骤相当基础,但仍然管用:
- 运行
pwd查看你所在的目录。你只能编辑此目录内的文件。 - 阅读 git 日志与进度文件,了解最近做了哪些工作。
- 阅读功能清单文件,挑一个尚未完成、优先级最高的功能来做。
这种做法在每个会话中都能为 Claude 省下一些 token,因为它不必再琢磨如何测试代码。此外,让初始化智能体写一个能启动开发服务器的 init.sh 脚本,并在实现新功能前先跑一遍基本的端到端测试,也很有帮助。
以 claude.ai 克隆版为例,这意味着智能体总是先启动本地开发服务器,再用 Puppeteer MCP 开一个新对话、发一条消息并收到回复。这能确保 Claude 快速发现应用是否处于损坏状态,并立刻修复已有的缺陷。如果智能体不这么做,而是直接开始实现新功能,很可能会让问题变得更糟。
有了这一切,一次典型会话的开场大致如下:
[Assistant] I'll start by getting my bearings and understanding the current state of the project.[Tool Use] <bash - pwd>[Tool Use] <read - claude-progress.txt>[Tool Use] <read - feature_list.json>[Assistant] Let me check the git log to see recent work.[Tool Use] <bash - git log --oneline -20>[Assistant] Now let me check if there's an init.sh script to restart the servers.<Starts the development server>[Assistant] Excellent! Now let me navigate to the application and verify that some fundamental features are still working.<Tests basic functionality>[Assistant] Based on my verification testing, I can see that the fundamental functionality is working well. The core chat features, theme switching, conversation loading, and error handling are all functioning correctly. Now let me review the tests.json file more comprehensively to understand what needs to be implemented next.<Starts work on a new feature>智能体的失败模式与解决方案
| 问题 | 初始化智能体的行为 | 编码智能体的行为 |
|---|---|---|
| Claude 过早宣布整个项目已完成。 | 建立功能清单文件:根据输入规格,建立一个结构化 JSON 文件,内含一系列端到端功能描述。 | 会话开始时先阅读功能清单文件,然后挑一个功能开始做。 |
| Claude 把环境留在了有缺陷或进度未记录的状态。 | 写入初始 git 仓库和进度记录文件。 | 会话开始时先阅读进度记录文件和 git 提交日志,并在开发服务器上跑一个基础测试,以发现任何未记录的缺陷;会话结束时提交 git 并更新进度。 |
| Claude 过早地把功能标记为完成。 | 建立功能清单文件。 | 对所有功能进行自我验证,只有在认真测试通过后,才把功能标记为「通过(passing)」。 |
| Claude 不得不花时间琢磨如何运行应用。 | 编写一个能启动开发服务器的 init.sh 脚本。 | 会话开始时先阅读 init.sh。 |
上表总结了长时运行智能体中的四种常见失败模式及其解决方案。
未来工作
这项研究展示了长时运行智能体框架中的一套可行解决方案,使模型能够在多个上下文窗口间取得渐进进展。不过,仍然存在一些开放性问题。
最值得注意的是,目前尚不清楚究竟是单个通用型编码智能体在跨上下文时表现最佳,还是通过多智能体架构能取得更好的表现。合理的猜想是,像测试智能体、质量保障智能体或代码清理智能体这样的专职智能体,或许能在软件开发生命周期的各个子任务上做得更好。
此外,这个演示是针对全栈 Web 应用开发做了优化的。未来的一个方向是把这些发现推广到其他领域。这些经验中的一部分或全部,很可能也适用于科学研究和金融建模等场景所需要的那类长时运行智能体任务。
致谢
作者
这项工作凝聚了 Anthropic 多个团队的集体努力,正是他们让 Claude 能够安全地进行长时间跨度的自主软件工程,尤其是 code RL 团队与 Claude Code 团队。有兴趣贡献的候选人欢迎到 anthropic.com/careers 申请。
脚注
1 我们在此把它们称为不同的智能体,仅仅是因为它们拥有不同的初始用户提示词。除此以外,系统提示词、工具集和整体智能体框架都是相同的。