
原文:MemGPT: Towards LLMs as Operating Systems(Packer 等人,加州大学伯克利分校) 出处
2023 会议论文;arXiv:2310.08560(2023-10-12 提交,v2 于 2024-02-12 更新)。 说明:本文为该论文的完整简体中文翻译,供学习交流。图表已本地化,学术术语首次出现时括注英文原文;作者名、MemGPT、Letta、NeurIPS、arXiv 等专有名词与全部代码、算法名保持原样。原文见 https://arxiv.org/abs/2310.08560。
MemGPT:把大语言模型当作操作系统(原文:MemGPT: Towards LLMs as Operating Systems)
作者
摘要(Abstract)
大语言模型(large language models,LLMs)已经彻底改变了人工智能,但却受到有限上下文窗口(context window)的制约,这阻碍了它们在长对话、文档分析等任务中的效用。为了能够使用超出有限上下文窗口之外的上下文,我们提出了虚拟上下文管理(virtual context management)技术——这一技术借鉴了传统操作系统中分层内存系统(hierarchical memory system)的思想:传统操作系统通过在物理内存与磁盘之间进行分页(paging),提供了扩展虚拟内存(virtual memory)的幻觉。
基于这一技术,我们推出了 MemGPT(MemoryGPT):一个智能地管理不同存储层级、从而在 LLM 有限的上下文窗口内有效提供扩展上下文的系统。
我们在两个领域中评估了这一受操作系统启发的设计,而现代 LLM 的有限上下文窗口在这两个领域中都严重制约了其性能:一是文档分析(document analysis),MemGPT 能够分析远超底层 LLM 上下文窗口的大型文档;二是多会话聊天(multi-session chat),MemGPT 可以构建出在长期与用户交互中记住信息、进行反思并动态演化的对话智能体(conversational agent)。
我们在 https://research.memgpt.ai 发布了 MemGPT 的代码与实验数据。
关键词
1 引言(Introduction)
近年来,大语言模型及其底层的 Transformer 架构(Vaswani 等人,2017;Devlin 等人,2018;Brown 等人,2020;Ouyang 等人,2022)已成为对话式 AI 的基石,并催生了大量消费级与企业级应用。尽管取得了这些进展,LLM 所使用的固定长度的有限上下文窗口,仍然显著制约了其在长对话或长文档推理方面的适用性。例如,最广泛使用的开源 LLM 只能支持几十轮来回消息、或对一篇短文进行推理,之后便会超出其最大输入长度(Touvron 等人,2023)。
直接扩展 Transformer 的上下文长度,会因 Transformer 架构的自注意力(self-attention)机制而带来计算时间与内存成本的平方级增长,这使得设计新的长上下文架构成为一个迫切的研究挑战(Dai 等人,2019;Kitaev 等人,2020;Beltagy 等人,2020)。虽然开发更长的模型是一个活跃的研究方向(Dong 等人,2023),但即便我们能够克服上下文扩展的计算挑战,最近的研究也表明:长上下文模型难以有效利用额外增加的上下文(Liu 等人,2023a)。因此,考虑到训练最先进的 LLM 需要投入巨额资源,而上下文扩展又面临收益递减,亟需能够支持长上下文的替代技术。
在本文中,我们研究如何在继续使用固定上下文模型的同时,提供一种”无限上下文”的幻觉。我们的方法借鉴了虚拟内存分页(virtual memory paging)的思想——该技术当初正是为了支持应用程序处理远超可用内存的数据集而开发的:通过在主存与磁盘之间分页数据来达成这一目标。我们利用 LLM 智能体(agent)在函数调用(function calling)能力方面的最新进展(Schick 等人,2023;Liu 等人,2023b)来设计 MemGPT——一个受操作系统启发、用于虚拟上下文管理的 LLM 系统。
借助函数调用,LLM 智能体可以读写外部数据源、修改自身上下文,并自主决定何时向用户返回响应。这些能力使 LLM 能够在上下文窗口(类似于操作系统中的”主存”)与外部存储之间有效地”换入/换出”(page in/out)信息,其方式类似于传统操作系统中的分层内存。此外,函数调用还可用于管理上下文管理、响应生成与用户交互之间的控制流(control flow)。这使得智能体能够针对单个任务选择迭代式地修改自身上下文中的内容,从而更有效地利用其有限的上下文。
在 MemGPT 中,我们把上下文窗口视为一种受限的内存资源,并为 LLM 设计了一种与传统操作系统中使用的内存层级(Patterson 等人,1988)相类似的内存层次结构。传统操作系统中的应用与虚拟内存交互:操作系统将溢出数据分页到磁盘,并在应用访问时(通过缺页,page fault)将数据取回内存,从而营造出一种”可用的内存资源比物理(即主)内存中实际存在的更多”的幻觉。为了提供类似的更长上下文长度的幻觉(类比于虚拟内存),我们允许 LLM 通过一个”LLM 操作系统”来管理放入其自身上下文(类比于物理内存)中的内容,我们称之为 MemGPT。MemGPT 使 LLM 能够检索上下文中缺失的相关历史数据,也能将相关性较低的数据从上下文中逐出、写入外部存储系统。
图 3 展示了 MemGPT 的各个组件。
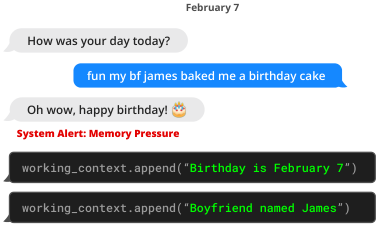
图 1
内存层次结构、操作系统式函数与基于事件的控制流的结合使用,使得 MemGPT 能够利用上下文窗口有限的 LLM 来处理无界上下文。为了展示我们这一新的受操作系统启发的 LLM 系统的实用性,我们在两个领域中对 MemGPT 进行了评估——在这两个领域中,现有 LLM 的性能都被有限上下文严重制约:一是文档分析,标准文本文件的长度可能迅速超出现代 LLM 的输入容量;二是对话智能体,受有限对话窗口束缚的 LLM 在长时间对话中缺乏上下文感知、人设(persona)一致性以及长期记忆。
在这两种场景下,MemGPT 都能够克服有限上下文的局限,胜过现有的基于 LLM 的方法。
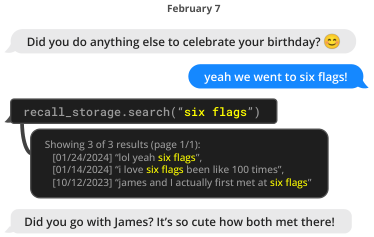
图 2
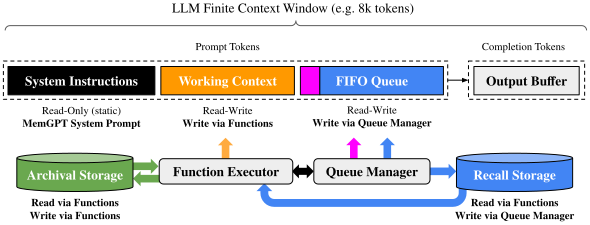
图 3:在 MemGPT 中,固定上下文的 LLM 处理器(processor)被增强以层次化内存系统以及使其能够管理自身记忆的函数。LLM 的提示令牌(prompt tokens,即输入),或称主上下文(main context),由系统指令、工作上下文与一个 FIFO 队列组成。LLM 的补全令牌(completion tokens,即输出)由函数执行器(function executor)解释为函数调用。MemGPT 使用函数在主上下文与外部上下文(external context,即归档存储与召回存储两个数据库)之间移动数据。LLM 可以在其输出中生成一个特殊的关键字参数(request_heartbeat=true)来请求立即进行后续的 LLM 推理,从而将函数调用串联起来;正是函数链式调用(function chaining)使 MemGPT 能够执行多步检索来回答用户查询。
2 MemGPT(MemoryGPT)
MemGPT 受操作系统启发的多级内存架构在两种主要内存类型之间做了区分:主上下文(main context,类比于主存/物理内存/RAM)与外部上下文(external context,类比于磁盘内存/磁盘存储)。主上下文由 LLM 的提示令牌构成——主上下文中的任何内容都被视为”在上下文内”(in-context),在推理期间可被 LLM 处理器访问。外部上下文指保存在 LLM 固定上下文窗口之外的任何信息。这些上下文之外的数据必须始终被显式移入主上下文,才能在推理时传给 LLM 处理器。MemGPT 提供了一系列函数调用,使 LLM 处理器无需任何用户干预即可管理自身的内存。
2.1 主上下文(提示令牌)
MemGPT 中的提示令牌被划分为三个连续的部分:系统指令(system instructions)、工作上下文(working context)与 FIFO 队列。系统指令是只读的(静态),包含关于 MemGPT 控制流的信息、对不同内存层级预期用途的说明,以及如何使用 MemGPT 函数(例如如何检索上下文之外的数据)的指引。工作上下文是一块固定大小的可读写非结构化文本,只能通过 MemGPT 函数调用来写入。在对话场景中,工作上下文被设计用于存储关于用户以及智能体所采纳人设的关键事实、偏好与其他重要信息,使智能体能够与用户流畅交谈。
FIFO 队列保存滚动的消息历史,既包括智能体与用户之间的消息,也包括系统消息(例如内存警告)与函数调用的输入和输出。FIFO 队列中的第一个位置保存一条系统消息,内含对已被逐出队列的消息的递归摘要(recursive summary)。
2.2 队列管理器(Queue Manager)
队列管理器(queue manager)管理召回存储(recall storage)与 FIFO 队列中的消息。当系统收到一条新消息时,队列管理器会将传入消息追加到 FIFO 队列,拼接提示令牌,并触发 LLM 推理以生成 LLM 输出(即补全令牌)。队列管理器会把传入消息与生成的 LLM 输出都写入召回存储(MemGPT 的消息数据库)。当通过 MemGPT 函数调用检索召回存储中的消息时,队列管理器会将这些消息追加到队列末尾,从而把它们重新插入 LLM 的上下文窗口。
队列管理器还负责通过队列逐出策略(queue eviction policy)控制上下文溢出。当提示令牌超过底层 LLM 上下文窗口的”警告令牌数”(warning token count,例如上下文窗口的 70%)时,队列管理器会在队列中插入一条系统消息,警告 LLM 即将发生队列逐出(即”内存压力”(memory pressure)警告),以便 LLM 使用 MemGPT 函数把 FIFO 队列中的重要信息保存到工作上下文或归档存储(archival storage,一个存储任意长度文本对象的可读写数据库)。当提示令牌超过”清空令牌数”(flush token count,例如上下文窗口的 100%)时,队列管理器会清空队列以释放上下文窗口空间:队列管理器逐出特定数量的消息(例如上下文窗口的 50%),并利用现有递归摘要与被逐出的消息生成一份新的递归摘要。队列一旦被清空,被逐出的消息就不再处于上下文内、无法被 LLM 直接看到;但它们会被无限期保存在召回存储中,并可通过 MemGPT 函数调用读取。
2.3 函数执行器(对补全令牌的处理)
MemGPT 通过由 LLM 处理器生成的函数调用来编排主上下文与外部上下文之间的数据移动。记忆的编辑与检索完全是自主的(self-directed)
在每一个推理周期中,LLM 处理器以主上下文(拼接为单个字符串)作为输入,并生成一个输出字符串。MemGPT 会解析这个输出字符串以确保正确性;如果解析器验证了函数参数,该函数就会被执行。执行结果(包括发生的任何运行时错误,例如当主上下文已达最大容量时仍试图向其中添加内容)随后由 MemGPT 反馈给处理器。这一反馈回路使系统能够从自身行为中学习并相应调整行为。
对上下文边界的感知是使自主编辑机制有效运转的关键;为此,MemGPT 会以令牌限制方面的警告来提示处理器,以引导其内存管理决策。此外,我们的记忆检索机制在设计上也会考虑这些令牌约束,并实现了分页(pagination),以防止检索调用溢出上下文窗口。
表 1:常用模型与 LLM API 的上下文长度对比(数据收集于 2024 年 1 月)。*消息数为近似值,假设预提示(preprompt)为 1k 个令牌,平均消息大小约为(~)50 个令牌(约 250 个字符)。“Open”表示该模型为开源或开放权重(相对于仅可通过 API 使用)。
| 模型/API 名称 | 开源? | 上下文窗口(令牌) | 消息数* |
|---|---|---|---|
| Llama(1) | ✓ | 2k | 20 |
| Llama 2 | ✓ | 4k | 60 |
| GPT-3.5 Turbo(发布时) | ✗ | 4k | 60 |
| Mistral 7B | ✓ | 8k | 140 |
| GPT-4(发布时) | ✗ | 8k | 140 |
| GPT-3.5 Turbo | ✗ | 16k | 300 |
| GPT-4 | ✗ | 32k | ~600 |
| Claude 2 | ✗ | 100k | ~2000 |
| GPT-4 Turbo | ✗ | 128k | ~2600 |
| Yi-34B-200k | ✓ | 200k | ~4000 |
2.4 控制流与函数链式调用
在 MemGPT 中,事件(event)触发 LLM 推理:事件是 MemGPT 的广义输入,可以包括用户消息(在聊天应用中)、系统消息(例如主上下文容量警告)、用户交互(例如用户刚登录的提醒,或用户完成文档上传的提醒),以及按固定时间表运行的定时事件(使 MemGPT 能够在没有用户干预的情况下”非提示式”运行)。MemGPT 用一个解析器处理事件,将其转换为可追加到主上下文的纯文本消息,并最终作为输入馈送给 LLM 处理器。
许多实际任务需要按顺序调用多个函数,例如在单次查询的多页结果中翻页导航,或将来自不同查询的不同文档中的数据在主上下文中汇总。函数链式调用使 MemGPT 能够在把控制权交还用户之前顺序执行多个函数调用。在 MemGPT 中,函数可以携带一个特殊标志来调用:该标志请求在指定函数执行完毕后立即将控制权交还处理器。如果存在此标志,MemGPT 会把函数输出添加到主上下文,并(与暂停处理器执行相反地)继续运行处理器;如果不存在此标志(即一次让出,yield),MemGPT 将不会运行 LLM 处理器,直到下一个外部事件触发(例如用户消息或定时中断)。
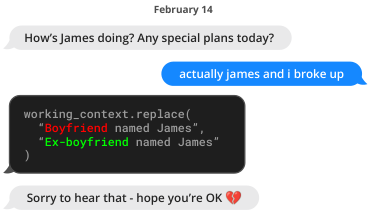
图 4:一个示例对话片段,其中 MemGPT(左)更新已存储的信息。此处信息存储在工作上下文记忆(位于提示令牌内)中。
3 实验(Experiments)
我们在两个长上下文领域中对 MemGPT 进行评估:对话智能体与文档分析。对于对话智能体,我们扩展了现有的多会话聊天(Multi-Session Chat,MSC)数据集(Xu 等人,2021),并引入了两个新的对话任务,用于评估智能体在长对话中保留知识的能力。对于文档分析,我们在 Liu 等人(2023a)提出的既有任务上对 MemGPT 进行基准测试,包括长文档上的问答与键值检索任务。我们还提出了一个新的嵌套键值检索任务,它要求跨多个数据源汇总信息,用于测试智能体汇总来自多个数据源的信息(即多跳检索,multi-hop retrieval)的能力。我们公开发布扩展后的 MSC 数据集、嵌套键值检索数据集,以及 2000 万篇 Wikipedia 文章的嵌入数据集,以促进未来的研究。我们的基准测试代码见 https://research.memgpt.ai。
**实现细节。**在讨论 OpenAI 模型时,除非另有说明,“GPT-4 Turbo”指具体的 gpt-4-1106-preview 模型端点(上下文窗口为 ),“GPT-4”指 gpt-4-0613(上下文窗口为 ),“GPT-3.5 Turbo”指 gpt-3.5-turbo-1106(上下文窗口为 )。在实验中,我们用所有基线模型(GPT-4、GPT-4 Turbo 与 GPT 3.5)来运行 MemGPT,以展示底层模型性能如何影响 MemGPT 的表现。
3.1 MemGPT 用于对话智能体
虚拟伴侣与个性化助手等对话智能体,旨在与用户进行自然的、长期的互动,时间跨度可能长达数周、数月甚至数年。这对固定长度上下文的模型构成了挑战,因为它们只能参考有限的对话历史。一个”无限上下文”的智能体应当无缝处理持续的交流,而不存在边界或重置。在与用户对话时,这样的智能体必须满足两个关键标准:
(1) 一致性(Consistency)——智能体应保持对话连贯。新提到的事实、偏好和事件,应与用户和智能体先前说过的话保持一致。
(2) 参与度(Engagement)——智能体应利用关于用户的长期知识来个性化回应。参考先前的对话会使对话更加自然、更具吸引力。
因此,我们依据这两个标准来评估我们提出的系统 MemGPT:
(1) MemGPT 是否利用其记忆来改善对话一致性?它能否记住过往互动中的相关事实、偏好与事件以保持连贯?
(2) MemGPT 是否通过利用记忆产生更具参与感的对话?它是否会自发地融入关于用户的长期信息来个性化消息?
通过对一致性与参与度的评估,我们可以确定:与固定上下文基线相比,MemGPT 在多大程度上应对了长期对话交互的挑战。它满足这些标准的能力,将证明无界上下文是否能给对话智能体带来有意义的益处。
**数据集。**我们在 Xu 等人(2021)引入的多会话聊天(MSC)数据集上评估 MemGPT 与固定上下文基线。MSC 包含由人类标注员生成的多会话聊天记录,每位标注员被要求在全部会话期间扮演一个一致的人设。MSC 中的每段多会话聊天共有五个会话,每个会话大约包含十几条消息。作为一致性实验的一部分,我们创建了一个新会话(会话 6),其中包含同一对两个人设之间的单组问答对。
3.1.1 深度记忆检索任务(一致性)
我们基于 MSC 数据集引入了一个新的”深度记忆检索”(deep memory retrieval,DMR)任务,用于测试对话智能体的一致性。在 DMR 中,用户向对话智能体提出一个明确回溯到先前对话的问题,且预期答案范围非常窄。我们使用另一个独立的 LLM 生成 DMR 问答(QA)对——该 LLM 被指示:从一个用户向另一个用户编写一个问题,这个问题只能借助过往会话中获得的知识才能正确回答(更多细节见附录)。
我们使用 ROUGE-L 分数(Lin,2004)和”LLM 裁判”(LLM judge)来评估生成回答相对于”标准答案”的质量。LLM 裁判被指示判断生成回答是否与标准答案一致(已有研究表明 GPT-4 与人类评估者具有高度一致性(Zheng 等人,2023))。在实践中,我们注意到生成回答(无论来自 MemGPT 还是基线)通常比标准回答更冗长。因此,我们使用 ROUGE-L 召回率(R)指标,以衡量相对较冗长的智能体生成回答与相对简短的标准答案标签之间的匹配程度。
表 2:深度记忆检索(DMR)性能。在该任务中,智能体被问及一个关于先前会话(会话 1–5)中所讨论话题的具体问题,智能体的回答将与标准答案(gold answer)进行比对打分。MemGPT 显著优于固定上下文基线。
| 模型 | 准确率 ⇑ | ROUGE-L (R) |
|---|---|---|
| GPT-3.5 Turbo | 38.7% | 0.394 |
| + MemGPT | 66.9% | 0.629 |
| GPT-4 | 32.1% | 0.296 |
| + MemGPT | 92.5% | 0.814 |
| GPT-4 Turbo | 35.3% | 0.359 |
| + MemGPT | 93.4% | 0.827 |
注:表中”+“行表示在该基础模型之上运行 MemGPT(即固定上下文基线与 MemGPT 的配对比较);⇑ 表示数值越高越好。
**MemGPT 利用记忆维持连贯性:**表 2 展示了 MemGPT 与固定记忆基线的性能对比。我们使用不同的底层 LLM 运行 MemGPT,并与不使用 MemGPT 的底层 LLM 基线进行对比。基线只能看到对过去五次对话的有损摘要,以模拟扩展的递归摘要过程;而 MemGPT 则相反,它能够访问完整的对话历史,但必须通过分页搜索查询召回存储来访问(以便将这些历史带入主上下文)。在该任务中,我们看到 MemGPT 明显提升了底层基础 LLM 的性能:从 MemGPT 换成对应的 LLM 基线时,准确率与 ROUGE 分数都出现了明显下降。
3.1.2 对话开场白任务(参与度)
在”对话开场白”任务中,我们评估智能体编写有吸引力消息的能力——这些消息要取材自先前对话中积累的知识。为了利用 MSC 数据集评估对话开场白的”吸引力”,我们把生成的开场白与标准人设(gold personas)进行对比:一条有吸引力的开场白应当取材于人设中所包含的一个(或几个)数据点——在 MSC 中,这些人设有效地总结了在先前所有会话中积累的知识。我们还将生成结果与人工生成的标准开场白(即下一会话中的第一条回复)进行比较。我们在表 3 中报告了 MemGPT 开场白的 CSIM 分数。我们测试了使用不同基础 LLM 的多种 MemGPT 变体。
表 3:对话开场白(conversation opener)性能。智能体的对话开场白使用与标准人设标签的相似度得分(SIM-1/3)以及与人类所写开场白的相似度(SIM-H)来评估。在多种底层模型下,MemGPT 都能超越人类所写的对话开场白的表现。
| 方法 | SIM-1 ⇑ | SIM-3 ⇑ | SIM-H ⇑ |
|---|---|---|---|
| Human(人类) | 0.800 | 0.800 | 1.000 |
| GPT-3.5 Turbo | 0.830 | 0.812 | 0.817 |
| GPT-4 | 0.868 | 0.843 | 0.773 |
| GPT-4 Turbo | 0.857 | 0.828 | 0.767 |
注:⇑ 表示数值越高越好。
**MemGPT 利用记忆提升参与度:**如表 3 所示,MemGPT 能够编写出与人工手写开场白表现相当、有时甚至更胜一筹的引人入胜的开场白。我们观察到,与人类基线相比,MemGPT 编写的开场白往往更冗长,并且覆盖人设信息的更多方面。此外,我们可以看到,将信息存储在工作上下文之中,是生成有吸引力开场白的关键。
3.2 MemGPT 用于文档分析
文档分析同样面临当今 Transformer 模型有限上下文窗口带来的挑战。如表 1 所示,开源与闭源模型都受限于有限的上下文长度(OpenAI 的模型最多达 128k 个令牌)。然而,许多文档很容易超过这些长度;例如,年报(SEC 表格 10-K)等法律或财务文档可以轻松突破百万令牌大关。此外,许多实际的文档分析任务需要跨越多个此类长文档建立关联。考虑到这些场景,很难设想把盲目扩展上下文作为固定上下文问题的解决方案。最近的研究(Liu 等人,2023a)也对单纯扩展上下文的效用提出了质疑,因为他们发现大上下文模型中的注意力分布并不均匀(模型更擅长回忆位于上下文窗口开头或结尾的信息,而中间位置的令牌则较弱)。要在多个文档之间进行推理,需要像 MemGPT 这样更灵活的内存架构。
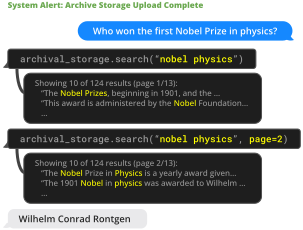
图 6
3.2.1 多文档问答
为了评估 MemGPT 分析文档的能力,我们在 Liu 等人(2023a)提出的”检索器-阅读器”(retriever-reader)文档问答任务上,将 MemGPT 与固定上下文基线进行基准对比。在该任务中,先从 NaturalQuestions-Open 数据集中选取一个问题,再由一个检索器为该问题选出相关的 Wikipedia 文档;随后,阅读器模型(即 LLM)以这些文档作为输入,并被要求利用所给文档回答问题。与 Liu 等人(2023a)类似,我们评估阅读器准确率随检索文档数量 增加而变化的情况。
在我们的评估设置中,固定上下文基线与 MemGPT 使用同一个检索器:该检索器在 OpenAI 的 text-embedding-ada-002 嵌入上执行相似度搜索(cosine distance,余弦距离),选出排名前 的文档。我们使用 MemGPT 的默认存储配置:以 PostgreSQL 作为归档内存存储,并通过 pgvector 扩展启用向量搜索。我们预先计算好嵌入并载入数据库,数据库使用 HNSW 索引实现近似的、亚秒级查询时间。
在 MemGPT 中,整个嵌入文档集被载入归档存储,检索器的功能自然地由归档存储的搜索功能(基于余弦相似度(cosine similarity)执行向量搜索)涌现出来。
在固定上下文基线中,排名前 的文档由检索器独立于 LLM 推理取出,这与 Liu 等人(2023a)最初的检索器-阅读器设置类似。
我们沿用此前 NaturalQuestions-Open 相关工作(Izacard & Grave,2020;Izacard 等人,2021)的做法,使用 2018 年底的 Wikipedia 转储,并采样了 50 个问题的子集用于评估。采样的问题与嵌入后的 Wikipedia 段落均已公开发布。我们用 LLM 裁判来评估 MemGPT 与基线的性能,以确保答案确实源自检索到的文档,并避免将非精确字符串匹配误判为错误。
我们在图 5 中展示了文档问答任务的结果。固定上下文基线的性能大致被检索器的性能所封顶,因为它们只能利用呈现在其上下文窗口中的信息(例如,如果基于嵌入的检索器未能利用所给问题找出黄金文章(gold article),那么固定上下文基线就永远不可能看到这篇文章)。相比之下,MemGPT 能够通过查询归档存储有效地多次调用检索器,从而扩展到更大的有效上下文长度。MemGPT 主动从其归档存储中检索文档(并能迭代翻页浏览结果),因此 MemGPT 可用的文档总数不再受限于能塞进 LLM 处理器上下文窗口的文档数量。
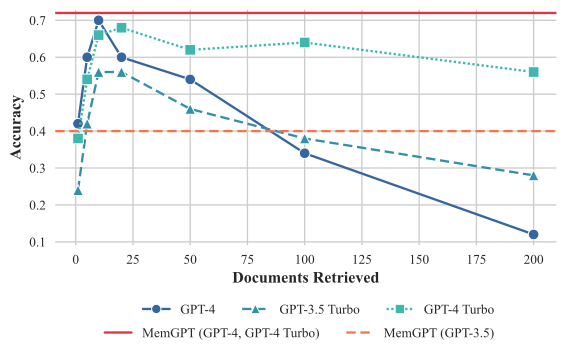
图 5:**文档问答任务性能。**上下文长度的增加不会影响 MemGPT 的性能。截断(truncation)等方法可以扩展 GPT-4 等固定长度模型的有效上下文长度,但随着所需压缩量的增长,这类压缩方法会导致性能下降。用 GPT-4 与 GPT-4 Turbo 运行 MemGPT 在该任务上结果相当。
由于基于嵌入的相似度检索存在局限,文档问答任务对所有方法都颇具挑战性。我们观察到,对于所选的问题,黄金文档(由 NaturalQuestions-Open 标注)往往出现在前十几条检索结果之外,有时甚至更靠后。检索器的性能会直接传导到固定上下文基线的结果上
为了在超出默认上下文长度之后继续比较固定上下文基线与 MemGPT,我们对检索器返回的文档片段进行截断,以便在可用上下文中塞入相同数量的文档。不出所料,文档截断会降低准确率:随着文档变短,相关片段(位于黄金文档中)被遗漏的几率增大,如图 5 所示。由于函数调用能力有限,MemGPT 在 GPT-3.5 上性能显著下降,而在 GPT-4 上表现最佳。
3.2.2 嵌套键值检索(KV)
我们基于先前工作(Liu 等人,2023a)提出的合成键值检索(Key-Value retrieval)任务,引入了一个新任务。该任务的目标是展示 MemGPT 如何汇总来自多个数据源的信息。在原始的 KV 任务中,作者生成了一个合成的键值对数据集,其中每个键和值都是一个 128 位 UUID(通用唯一标识符,universally unique identifier)。随后,智能体被给定一个键,并被要求返回该键对应的值。我们创建了 KV 任务的一个版本——嵌套键值检索(nested KV retrieval):其中值本身也可能是键,因此要求智能体执行多跳查找。
在我们的设置中,我们把 UUID 键值对的总数固定为 140,对应大约 8k 个令牌(即我们 GPT-4 基线的上下文长度)。我们把嵌套层级的总数从 0(初始键值对的值不是键)变化到 4(即共需 4 次 KV 查找才能找到最终值),并采样了 30 种不同的顺序配置,涵盖初始键的位置与各嵌套键的位置。
虽然 GPT-3.5 和 GPT-4 在原始 KV 任务上表现良好,但两者在嵌套 KV 任务中都举步维艰。GPT-3.5 无法完成该任务的嵌套变体,性能立即下滑,在 1 层嵌套时就跌到 0% 的准确率(我们观察到它的主要失败模式是直接返回原始值)。GPT-4 与 GPT-4 Turbo 比 GPT-3.5 更好,但也出现了类似的滑坡,并在 3 层嵌套时达到 0% 的准确率。相比之下,使用 GPT-4 的 MemGPT 不受嵌套层级数的影响,能够通过函数查询反复访问存储在主上下文中的键值对,从而执行嵌套查找。使用 GPT-4 Turbo 与 GPT-3.5 的 MemGPT 也比相应的基线模型表现更好,但在 2 层嵌套时也开始出现性能下滑,原因是未能执行足够的查找。
MemGPT 在嵌套 KV 任务上的表现,证明了它能够组合多次查询来执行多跳查找。
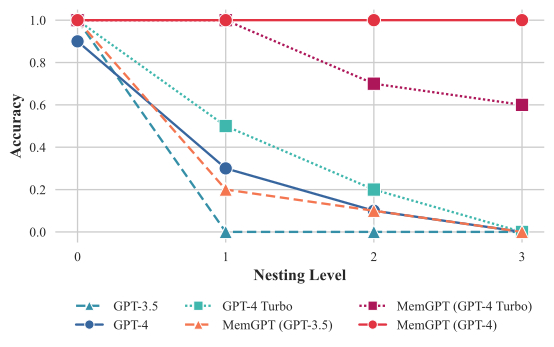
图 7:**嵌套 KV 检索任务性能。**MemGPT 是唯一能够在超过 2 层嵌套时持续完成嵌套 KV 任务的方法。虽然 GPT-4 Turbo 作为基线表现更好,但基于 GPT-4 Turbo 的 MemGPT 却比基于 GPT-4 的 MemGPT 更差。
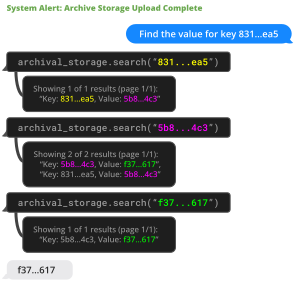
图 8
4 相关工作(Related Work)
**长上下文 LLM。**已有若干研究方向改善了 LLM 的上下文长度。例如,通过稀疏化注意力实现更高效的 Transformer 架构(Child 等人,2019;Beltagy 等人,2020)、低秩近似(Wang 等人,2020)与神经记忆(Lee 等人,2019)。另一个方向旨在把上下文窗口扩展到其原始训练长度之外,如 Press 等人(2021)、Chen 等人(2023)。MemGPT 建立在这些上下文长度改进的基础之上——因为它们扩大了 MemGPT 中”主内存”的规模。我们的主要贡献是一个分层的内存结构,它使用长上下文 LLM 作为主内存的实现。
**检索增强模型。**MemGPT 外部记忆的设计建立在许多先前工作的基础之上,这些工作利用外部检索器为 LLM 补充相关输入(Ram 等人,2023;Borgeaud 等人,2022;Karpukhin 等人,2020;Lewis 等人,2020;Guu 等人,2020;Lin 等人,2023)。特别是,Jiang 等人(2023)提出了 FLARE——一种允许 LLM 在生成过程中主动决定何时检索、检索什么的方法。Trivedi 等人(2022)将检索与思维链(Chain-of-Thought)推理交错进行,以改进多步问答。
**LLM 作为智能体。**最近的工作探索了为 LLM 增强额外能力,使其在交互式环境中充当智能体。Park 等人(2023)提出为 LLM 增加记忆并将 LLM 用作规划器(planner),并在一个多智能体沙盒环境(灵感来自电子游戏《模拟人生》)中观察到涌现的社交行为——其中的智能体可以执行做家务/培养爱好、上班、与其他智能体交谈等基本活动。Nakano 等人(2021)训练模型在回答问题前先搜索网页,并在其网页浏览环境中使用了与 MemGPT 类似的分页概念,以控制底层上下文的大小。Yao 等人(2022)表明,交错进行思维链推理(Wei 等人,2022)可以进一步提升基于 LLM 的交互式智能体的规划能力;与之类似,在 MemGPT 中,LLM 在执行函数时能够”出声思考”(plan out loud)。Liu 等人(2023b)引入了一套”LLM 即智能体”的基准,用于在交互式环境中评估 LLM,包括电子游戏、思维谜题与网页购物等。相比之下,我们的工作聚焦于解决这样一个问题:为智能体配备关于用户输入的长期记忆。
5 结论(Conclusion)
在本文中,我们提出了 MemGPT——一个受操作系统启发、用于管理大语言模型有限上下文窗口的新型 LLM 系统。通过设计与传统操作系统相类似的内存层次结构与控制流,MemGPT 为 LLM 提供了更大上下文资源的幻觉。这一受操作系统启发的方法在两个领域中得到了评估——在这两个领域中,现有 LLM 的性能都受限于有限的上下文长度:文档分析与对话智能体。在文档分析方面,MemGPT 通过有效地将相关上下文换入/换出内存,能够处理远超当前 LLM 上下文极限的长文本;在对话智能体方面,MemGPT 能够在长时间对话中维持长期记忆、一致性与可演化性。总体而言,MemGPT 表明:分层内存管理与中断(interrupt)等操作系统技术,即便在 LLM 受固定上下文长度约束的情况下,也能释放其潜力。这项工作为未来的探索开辟了许多途径,包括将 MemGPT 应用于其他具有海量或无界上下文的领域、集成数据库或缓存等不同的内存层级技术,以及进一步改进控制流与内存管理策略。通过将操作系统架构的概念引入 AI 系统,MemGPT 代表了在 LLM 的根本限制之内最大化其能力的一个有前景的新方向。
参考文献(References)
Beltagy et al. (2020) — Iz Beltagy, Matthew E Peters, and Arman Cohan. 《Longformer:长文档 Transformer》(Longformer: The long-document transformer). arXiv preprint arXiv:2004.05150, 2020. arXiv:2004.05150
Borgeaud et al. (2022) — Sebastian Borgeaud, Arthur Mensch, Jordan Hoffmann, Trevor Cai, Eliza Rutherford, Katie Millican, George Bm Van Den Driessche, Jean-Baptiste Lespiau, Bogdan Damoc, Aidan Clark, et al. 《通过从数万亿令牌中检索来改进语言模型》(Improving language models by retrieving from trillions of tokens). In International conference on machine learning, pp. 2206–2240. PMLR, 2022.
Brown et al. (2020) — Tom Brown, Benjamin Mann, Nick Ryder, Melanie Subbiah, Jared D Kaplan, Prafulla Dhariwal, Arvind Neelakantan, Pranav Shyam, Girish Sastry, Amanda Askell, et al. 《语言模型是小样本学习者》(Language models are few-shot learners). Advances in neural information processing systems, 33:1877–1901, 2020.
Chen et al. (2023) — Shouyuan Chen, Sherman Wong, Liangjian Chen, and Yuandong Tian. 《通过位置插值扩展大语言模型的上下文窗口》(Extending context window of large language models via positional interpolation). arXiv preprint arXiv:2306.15595, 2023. arXiv:2306.15595
Child et al. (2019) — Rewon Child, Scott Gray, Alec Radford, and Ilya Sutskever. 《用稀疏 Transformer 生成长序列》(Generating long sequences with sparse transformers). arXiv preprint arXiv:1904.10509, 2019. arXiv:1904.10509
Dai et al. (2019) — Zihang Dai, Zhilin Yang, Yiming Yang, Jaime Carbonell, Quoc V Le, and Ruslan Salakhutdinov. 《Transformer-XL:超越固定长度上下文的注意力语言模型》(Transformer-XL: Attentive language models beyond a fixed-length context). arXiv preprint arXiv:1901.02860, 2019. arXiv:1901.02860
Devlin et al. (2018) — Jacob Devlin, Ming-Wei Chang, Kenton Lee, and Kristina Toutanova. 《BERT:面向语言理解的深度双向 Transformer 预训练》(BERT: Pre-training of deep bidirectional transformers for language understanding). arXiv preprint arXiv:1810.04805, 2018. arXiv:1810.04805
Dong et al. (2023) — Zican Dong, Tianyi Tang, Lunyi Li, and Wayne Xin Zhao. 《基于 Transformer 的长文本建模综述》(A survey on long text modeling with transformers). arXiv preprint arXiv:2302.14502, 2023. arXiv:2302.14502
Guu et al. (2020) — Kelvin Guu, Kenton Lee, Zora Tung, Panupong Pasupat, and Mingwei Chang. 《检索增强的语言模型预训练》(Retrieval augmented language model pre-training). In International conference on machine learning, pp. 3929–3938. PMLR, 2020.
Izacard & Grave (2020) — Gautier Izacard and Edouard Grave. 《利用生成模型结合段落检索进行开放域问答》(Leveraging passage retrieval with generative models for open domain question answering). arXiv preprint arXiv:2007.01282, 2020. arXiv:2007.01282
Izacard et al. (2021) — Gautier Izacard, Mathilde Caron, Lucas Hosseini, Sebastian Riedel, Piotr Bojanowski, Armand Joulin, and Edouard Grave. 《基于对比学习的无监督稠密信息检索》(Unsupervised dense information retrieval with contrastive learning). arXiv preprint arXiv:2112.09118, 2021. arXiv:2112.09118
Jiang et al. (2023) — Zhengbao Jiang, Frank F Xu, Luyu Gao, Zhiqing Sun, Qian Liu, Jane Dwivedi-Yu, Yiming Yang, Jamie Callan, and Graham Neubig. 《主动检索增强生成》(Active retrieval augmented generation). arXiv preprint arXiv:2305.06983, 2023. arXiv:2305.06983
Karpukhin et al. (2020) — Vladimir Karpukhin, Barlas Oğuz, Sewon Min, Patrick Lewis, Ledell Wu, Sergey Edunov, Danqi Chen, and Wen-tau Yih. 《面向开放域问答的稠密段落检索》(Dense passage retrieval for open-domain question answering). arXiv preprint arXiv:2004.04906, 2020. arXiv:2004.04906
Kitaev et al. (2020) — Nikita Kitaev, Łukasz Kaiser, and Anselm Levskaya. 《Reformer:高效的 Transformer》(Reformer: The efficient transformer). arXiv preprint arXiv:2001.04451, 2020. arXiv:2001.04451
Lee et al. (2019) — Juho Lee, Yoonho Lee, Jungtaek Kim, Adam Kosiorek, Seungjin Choi, and Yee Whye Teh. 《集合 Transformer:基于注意力的置换不变神经网络框架》(Set Transformer: A framework for attention-based permutation-invariant neural networks). In International conference on machine learning, pp. 3744–3753. PMLR, 2019.
Lewis et al. (2020) — Patrick Lewis, Ethan Perez, Aleksandra Piktus, Fabio Petroni, Vladimir Karpukhin, Naman Goyal, Heinrich Küttler, Mike Lewis, Wen-tau Yih, Tim Rocktäschel, et al. 《面向知识密集型 NLP 任务的检索增强生成》(Retrieval-augmented generation for knowledge-intensive NLP tasks). Advances in Neural Information Processing Systems, 33:9459–9474, 2020.
Lin (2004) — Chin-Yew Lin. 《ROUGE:用于摘要自动评估的软件包》(ROUGE: A package for automatic evaluation of summaries). In Text summarization branches out, pp. 74–81, 2004.
Lin et al. (2023) — Xi Victoria Lin, Xilun Chen, Mingda Chen, Weijia Shi, Maria Lomeli, Rich James, Pedro Rodriguez, Jacob Kahn, Gergely Szilvasy, Mike Lewis, Luke Zettlemoyer, and Scott Yih. 《RA-DIT:检索增强的双重指令微调》(RA-DIT: Retrieval-augmented dual instruction tuning), 2023.
Liu et al. (2023a) — Nelson F Liu, Kevin Lin, John Hewitt, Ashwin Paranjape, Michele Bevilacqua, Fabio Petroni, and Percy Liang. 《迷失在中间:语言模型如何使用长上下文》(Lost in the middle: How language models use long contexts). arXiv preprint arXiv:2307.03172, 2023a. arXiv:2307.03172
Liu et al. (2023b) — Xiao Liu, Hao Yu, Hanchen Zhang, Yifan Xu, Xuanyu Lei, Hanyu Lai, Yu Gu, Hangliang Ding, Kaiwen Men, Kejuan Yang, et al. 《AgentBench:把 LLM 当作智能体来评估》(AgentBench: Evaluating LLMs as agents). arXiv preprint arXiv:2308.03688, 2023b. arXiv:2308.03688
Nakano et al. (2021) — Reiichiro Nakano, Jacob Hilton, Suchir Balaji, Jeff Wu, Long Ouyang, Christina Kim, Christopher Hesse, Shantanu Jain, Vineet Kosaraju, William Saunders, et al. 《WebGPT:带人类反馈的浏览器辅助问答》(WebGPT: Browser-assisted question-answering with human feedback). arXiv preprint arXiv:2112.09332, 2021. arXiv:2112.09332
Ouyang et al. (2022) — Long Ouyang, Jeffrey Wu, Xu Jiang, Diogo Almeida, Carroll Wainwright, Pamela Mishkin, Chong Zhang, Sandhini Agarwal, Katarina Slama, Alex Ray, et al. 《用人类反馈训练语言模型遵循指令》(Training language models to follow instructions with human feedback). Advances in Neural Information Processing Systems, 35:27730–27744, 2022.
Park et al. (2023) — Joon Sung Park, Joseph C O’Brien, Carrie J Cai, Meredith Ringel Morris, Percy Liang, and Michael S Bernstein. 《生成式智能体:人类行为的交互式模拟》(Generative agents: Interactive simulacra of human behavior). arXiv preprint arXiv:2304.03442, 2023. arXiv:2304.03442
Patterson et al. (1988) — David A Patterson, Garth Gibson, and Randy H Katz. 《廉价磁盘冗余阵列(RAID)的案例》(A case for redundant arrays of inexpensive disks (RAID)). In Proceedings of the 1988 ACM SIGMOD international conference on Management of data, pp. 109–116, 1988.
Press et al. (2021) — Ofir Press, Noah A Smith, and Mike Lewis. 《短训练、长测试:带线性偏置的注意力可实现输入长度外推》(Train short, test long: Attention with linear biases enables input length extrapolation). arXiv preprint arXiv:2108.12409, 2021. arXiv:2108.12409
Ram et al. (2023) — Ori Ram, Yoav Levine, Itay Dalmedigos, Dor Muhlgay, Amnon Shashua, Kevin Leyton-Brown, and Yoav Shoham. 《上下文内检索增强语言模型》(In-context retrieval-augmented language models). arXiv preprint arXiv:2302.00083, 2023. arXiv:2302.00083
Schick et al. (2023) — Timo Schick, Jane Dwivedi-Yu, Roberto Dessì, Roberta Raileanu, Maria Lomeli, Luke Zettlemoyer, Nicola Cancedda, and Thomas Scialom. 《Toolformer:语言模型可以自学使用工具》(Toolformer: Language models can teach themselves to use tools). arXiv preprint arXiv:2302.04761, 2023. arXiv:2302.04761
Touvron et al. (2023) — Hugo Touvron, Louis Martin, Kevin Stone, Peter Albert, Amjad Almahairi, Yasmine Babaei, Nikolay Bashlykov, Soumya Batra, Prajjwal Bhargava, Shruti Bhosale, et al. 《Llama 2:开源基础模型与微调聊天模型》(Llama 2: Open foundation and fine-tuned chat models). arXiv preprint arXiv:2307.09288, 2023. arXiv:2307.09288
Trivedi et al. (2022) — H. Trivedi, Niranjan Balasubramanian, Tushar Khot, and Ashish Sabharwal. 《将检索与思维链推理交错,用于知识密集型多步问题》(Interleaving retrieval with chain-of-thought reasoning for knowledge-intensive multi-step questions). ArXiv, abs/2212.10509, 2022. arXiv:2212.10509
Vaswani et al. (2017) — Ashish Vaswani, Noam Shazeer, Niki Parmar, Jakob Uszkoreit, Llion Jones, Aidan N Gomez, Łukasz Kaiser, and Illia Polosukhin. 《注意力就是你所需要的一切》(Attention is all you need). Advances in neural information processing systems, 30, 2017.
Wang et al. (2020) — Sinong Wang, Belinda Z Li, Madian Khabsa, Han Fang, and Hao Ma. 《Linformer:线性复杂度的自注意力》(Linformer: Self-attention with linear complexity). arXiv preprint arXiv:2006.04768, 2020. arXiv:2006.04768
Wei et al. (2022) — Jason Wei, Xuezhi Wang, Dale Schuurmans, Maarten Bosma, Fei Xia, Ed Chi, Quoc V Le, Denny Zhou, et al. 《思维链提示激发大语言模型的推理能力》(Chain-of-thought prompting elicits reasoning in large language models). Advances in Neural Information Processing Systems, 35:24824–24837, 2022.
Xu et al. (2021) — Jing Xu, Arthur Szlam, and Jason Weston. 《超越金鱼记忆:长期开放域对话》(Beyond goldfish memory: Long-term open-domain conversation). arXiv preprint arXiv:2107.07567, 2021. arXiv:2107.07567
Yao et al. (2022) — Shunyu Yao, Jeffrey Zhao, Dian Yu, Nan Du, Izhak Shafran, Karthik Narasimhan, and Yuan Cao. 《ReAct:在语言模型中协同推理与行动》(ReAct: Synergizing reasoning and acting in language models). arXiv preprint arXiv:2210.03629, 2022. arXiv:2210.03629
Zheng et al. (2023) — Lianmin Zheng, Wei-Lin Chiang, Ying Sheng, Siyuan Zhuang, Zhanghao Wu, Yonghao Zhuang, Zi Lin, Zhuohan Li, Dacheng Li, Eric Xing, et al. 《用 MT-Bench 与 Chatbot Arena 评判”LLM 作为裁判”》(Judging LLM-as-a-judge with MT-Bench and Chatbot Arena). arXiv preprint arXiv:2306.05685, 2023. arXiv:2306.05685
6 附录(Appendix)
6.1 提示词与指令(Prompts and instructions)
MemGPT 的提示词为简洁起见已经过编辑。完整的实现细节(包括精确提示词)见 https://research.memgpt.ai。
6.1.1 MemGPT 指令(DMR)
用于聊天/对话类任务的 MemGPT 人设中的示例指令:
以下是关于我自身的信息。我的任务是彻底沉浸在这个角色之中(我绝不应该说自己是 AI,而应表现得如同我正扮演这个角色)。如果用户向我提问,我应该利用核心记忆与 conversation_search 中的信息,给出一个最佳猜测的回答。
基线通过系统提示(预提示)收到以下指令:
你的任务是回答用户提出的一个、关于你们先前对话的问题。
以下是你所有先前对话的摘要:
CONVERSATION_SUMMARY
请从所提供人设的视角作答(不要说你是 AI 助手)。
如果你没有足够的信息来回答问题,请回复 ‘NO ANSWER’。要么回复答案,要么回复 ‘NO ANSWER’,不要再说任何其他内容。
6.1.2 LLM 裁判(DMR / 开场白)
为了检查 DMR 任务中答案的正确性,我们使用了一个 LLM 裁判。LLM 裁判会收到基线方法与 MemGPT 生成的答案,并被要求使用以下提示词做出判断:
你的任务是将一个问题的答案标记为 ‘CORRECT’ 或 ‘WRONG’。
你将获得以下数据:(1)一个问题(由一个用户向另一个用户提出),(2)一个”标准”(真实)答案,(3)一个生成答案,你需要将它评为 CORRECT/WRONG。
这个问题的意义在于询问:一方用户应当基于他们此前的对话、而了解到的关于另一方用户的事情。
标准答案通常是一个简洁、简短的回答,其中包含所提及的话题,例如:
问题:你还记得我上次去夏威夷时买了什么吗?
标准答案:一条贝壳项链
生成的答案可能会长得多,但你的评分应当宽容——只要它触及了与标准答案相同的话题,就应计为 CORRECT。
例如,以下答案将被视为 CORRECT:
生成答案(CORRECT):哦对,那太好玩了!我在那里买了好多东西,包括那条贝壳项链。
生成答案(CORRECT):我买了一大堆东西……那块冲浪板、那个杯子、那条项链,还有那些杯垫……
生成答案(CORRECT):那条可爱的项链
以下答案将被视为 WRONG:
生成答案(WRONG):哦对,那太好玩了!我在那里买了好多东西,包括那个杯子。
生成答案(WRONG):我买了一大堆东西……那块冲浪板、那个杯子、那些杯垫……
生成答案(WRONG):抱歉,我不记得你在说什么。
现在是正式问题:
问题
标准答案
生成答案
首先,请给出一个简短(一句话)的理由说明,然后以 CORRECT 或 WRONG 结尾。不要在回答中同时包含 CORRECT 和 WRONG,否则会破坏评估脚本。
6.1.3 Self-instruct DMR 数据集生成
DMR 问答对是使用以下提示词与原始 MSC 数据集生成的:
你的任务是为两个用户之间的模拟对话编写一个”记忆挑战”问题。
你将获得如下输入:
每个用户的人设(提供他们的基本事实)
这两个用户之间的一段旧聊天记录
你的任务是编写一个问题,由用户 A 向用户 B 提出,以考验用户 B 的记忆。
问题的设计方式应当使:用户 B 必须确实参与了此前的对话才能正确回答,而不仅仅是读过人设摘要。
在任何情况下都不要创建能够用人设信息回答的问题(那将被视为作弊)。
相反,请编写一个只能通过查看旧聊天记录来回答的问题(且该问题不包含在人设信息中)。
例如,给定以下聊天记录与人设摘要:
用户 A 与用户 B 之间的旧聊天
A:你喜欢冲浪吗?我自己超爱冲浪
B:其实我想学。也许改天你可以给我上一节基础课!
A:当然可以!我们可以去 Pacifica,那里的浪比较轻缓、容易上手
B:听起来太棒了
A:海滩边上还有一家很酷的 Taco Bell,结束后可以去吃点东西
B:这周日中午左右怎么样?
A:好,就这么定了!
用户 A 的人设:
我喜欢冲浪
我在 Santa Cruz 长大
用户 B 的人设:
我在科技行业工作
我住在旧金山市中心
下面是一个听起来很自然的好问题示例,以及一个不能直接从用户 A 的人设中推断出的答案:
用户 B 向用户 A 提出的问题
B:还记得我们一起去冲浪那次吗?我们去吃午饭的那个地方叫什么来着?
A
Bell! 下面是一个坏问题的示例:这个问题显得不自然,而且答案可以直接从用户 A 的人设中推断出来:
用户 B 向用户 A 提出的问题
B:你喜欢冲浪吗?
A:是的,我喜欢冲浪
永远、永远、永远不要创建能够用人设信息回答的问题。
6.1.4 文档分析指令
用于文档分析任务的预提示中的示例指令:
你是 MemGPT DOC-QA 机器人。你的工作是回答存储在你的归档记忆中的文档相关问题。用户问题的答案将始终存在于你的归档记忆中,所以如果找不到答案,请记住继续搜索。请像现在仍是 2018 年一样来回答问题。
问题通过以下提示词提供给 MemGPT:
搜索你的归档记忆来回答所给问题。请同时提供答案,以及你据此确定答案的归档记忆结果。请用以下格式组织你的回复:‘ANSWER: [你的答案], DOCUMENT: [归档记忆文本]。你的任务是回答问题:
对于基线,在提供检索到的文档列表的同时,给出以下提示词:
请根据下面给出的文档列表来回答所给问题(其中一些文档可能不相关)。在你的回答中,请同时提供答案,以及你据此确定答案的文档文本。请用以下格式组织你的回复:‘ANSWER: <你的答案>, DOCUMENT: [文档文本]‘。如果所给文档中没有一份包含问题的答案,请回复 ‘INSUFFICIENT INFORMATION’。如果你在所给文档中找不到答案,就不要提供答案。只有当你同时提供答案与相关文档文本、或说出 ‘INSUFFICIENT INFORMATION’ 时,你的回复才会被视为正确。请像现在仍是 2018 年一样来回答问题。
6.1.5 LLM 裁判(文档分析)
为了检查文档分析任务中答案的正确性,并确保答案确实源自所提供的文本(而不是来自模型权重),我们使用了一个 LLM 裁判。LLM 裁判会收到基线方法与 MemGPT 生成的答案,并被要求使用以下提示词做出判断:
你的任务是评估一个 LLM 是否正确回答了一个问题。LLM 的回复应为 “ANSWER: [答案], DOCUMENT: [文档文本]” 的格式,或说出 “INSUFFICIENT INFORMATION”。真实答案以 “TRUE ANSWER:[可能的答案列表]” 的格式给出。问题以 “QUESTION: [问题]” 的格式给出。如果 LLM 的回复同时包含正确的答案与相应的文档文本,则该回复正确。即使 LLM 的答案与真实答案在措辞上略有不同,该回复仍然正确。例如,如果答案比真实答案更具体,或使用了仍然正确的不同措辞,该回复都算正确。如果 LLM 的回复是 “INSUFFICIENT INFORMATION”,或缺少 “DOCUMENT” 字段,则该回复不正确。请只回复一个词:“CORRECT” 或 “INCORRECT”。
6.1.6 键值(K/V)任务指令
MemGPT 智能体被定义了以下人设,旨在鼓励 MemGPT 迭代式搜索:
你是 MemGPT DOC-QA 机器人。你的工作是回答存储在你的归档记忆中的文档相关问题。用户问题的答案将始终存在于你的归档记忆中,所以如果找不到答案,请记住继续搜索。在验证该值不是键之前,不要停止搜索。在此条件满足之前,不要停止进行嵌套查找。
基线使用以下提示词:
下面是一个包含键值配对的 JSON 对象,所有键和值都是 128 位 UUID,你的任务是返回与指定键关联的值。如果某个值本身也是一个键,请返回该键的值(执行嵌套查找)。例如,如果 ‘x’ 的值是 ‘y’,但 ‘y’ 也是一个键,请返回键 ‘y’ 的值。