
原文:LLM Agent Memory Architecture: Types, Lifecycle, and Evaluation(Andy Agent Lab,作者 Tamar Peretz,2026-07-11 发布,2026-07-31 更新)。本文为简体中文翻译,插图来自原文。
设计 LLM 代理(agent)的记忆系统:涉及工作状态(working state)、持久记忆(persistent memory)类型、表示、存储、检索、更新与删除,以及端到端评估。
摘要
LLM 代理中的记忆不是单一组件。“记忆”这个词常被用来描述上下文窗口(context window)、对话历史、持久化的用户数据、检索到的文档、模型参数,以及外部数据库。这些机制在生命周期、表示方式、访问路径与运行角色上各不相同。把它们当作同一层来处理会犯范畴错误(category error):把更大的上下文窗口误当成长期记忆,把向量索引(vector index)当成完整的记忆架构,或仅仅因为对话历史被存储下来就想当然地认为它有用。
本文提出一个与厂商无关(vendor-agnostic)的代理记忆系统模型。它区分四个可分离的分析维度:时间范围(temporal scope)、功能角色(functional role)、表示形式(representation form)、存储与访问介质(storage and access substrate),然后把它们映射到一个记忆生命周期(memory lifecycle)上:捕获、写入选择、表示、校验、存储、索引、检索、上下文组装、使用、更新、整合与删除。
该模型综合了同行评审的代理架构文献、检索增强生成(retrieval-augmented generation,RAG)研究、长上下文评估与代理记忆基准。它不是一套普适分类法。它的目的是为分析与设计依赖记忆的 LLM 系统提供一套精确的工程词汇。
记忆是系统级能力,而非单一存储
LLM 不会仅仅因为某个应用向它发送了很长的提示词(prompt)、或保存了一份对话记录,就获得持久的记忆。在系统层面,记忆需要一系列机制,使较早的观察、交互或任务中的信息,能够影响之后的推理或行动。
一个有用的系统级定义是:
代理记忆(agent memory),是用于表示、留存、检索、选择与更新信息,使其能够影响未来模型调用(model invocation)或代理行动的那套机制。
这一定义把记忆与任何单一实现剥离开来。一个记忆系统可能使用关系数据库、事件日志、文档存储、向量索引、知识图谱、可执行过程、模型参数,或者其中若干种的组合。存储技术不决定记忆的功能类型;仅靠持久化(persistence),也不能保证被存储的信息会被正确检索或使用。
CoALA 为这一区分提供了最清晰的形式化架构之一。它把语言代理(language agent)建模为这样一个系统:包含工作记忆、可选的长期记忆组件、结构化的行动空间(action space)与决策过程。在其长期记忆模型中,情景、语义与程序性记忆承担着不同的功能角色[1]。
为什么 LLM 系统中的“记忆”一词含义过载
一些机制虽然解决的问题各不相同,却常被归入同一个标签之下。
| 术语 | 它描述什么 | 它不能确立什么 |
|---|---|---|
| 上下文窗口 | 单次模型调用可用的有界词元(token)容量,包括提供的输入、生成的输出,以及(如适用)额外的模型侧词元 | 跨未来调用或会话的持久化 |
| 对话状态(conversation state) | 跨轮次携带先前消息、工具调用、输出或其他条目的机制 | 结构化的记忆模型、检索策略或更新策略 |
| 持久化存储(persistent store) | 超出当前调用或会话而留存的数据 | 这些数据能否被正确检索、选择或使用 |
| 检索到的上下文(retrieved context) | 从外部来源选出、插入活跃模型输入的记录 | 这些记录是否正确、充分、最新或可信 |
| 参数化知识(parametric knowledge) | 隐式表示在学习所得模型参数中的信息 | 一种可像普通应用数据那样被检查、更新或删除的可审计记录 |
| 压缩或摘要后的状态 | 为继续一段长交互而对更早上下文所做的精简表示 | 完整的事实来源历史,或通用的长期记忆架构 |
因此,一套精确的架构必须回答的不只是“系统有没有记忆?”。它还必须明确:哪些信息处于活跃状态?什么被持久保存?信息以何种形式表示?何时被检索?冲突如何处理?当一条新记录取代更旧的记录时,会发生什么变化?
代理记忆的多维模型
对常见的“记忆分层”示意图,一个有用的修正方向是:不要再把短期记忆、长期记忆、情景记忆、语义记忆、程序性记忆当作五个并行的类别。
它们更适合被分析为若干可分离的维度,这些维度在实现中相互交织。
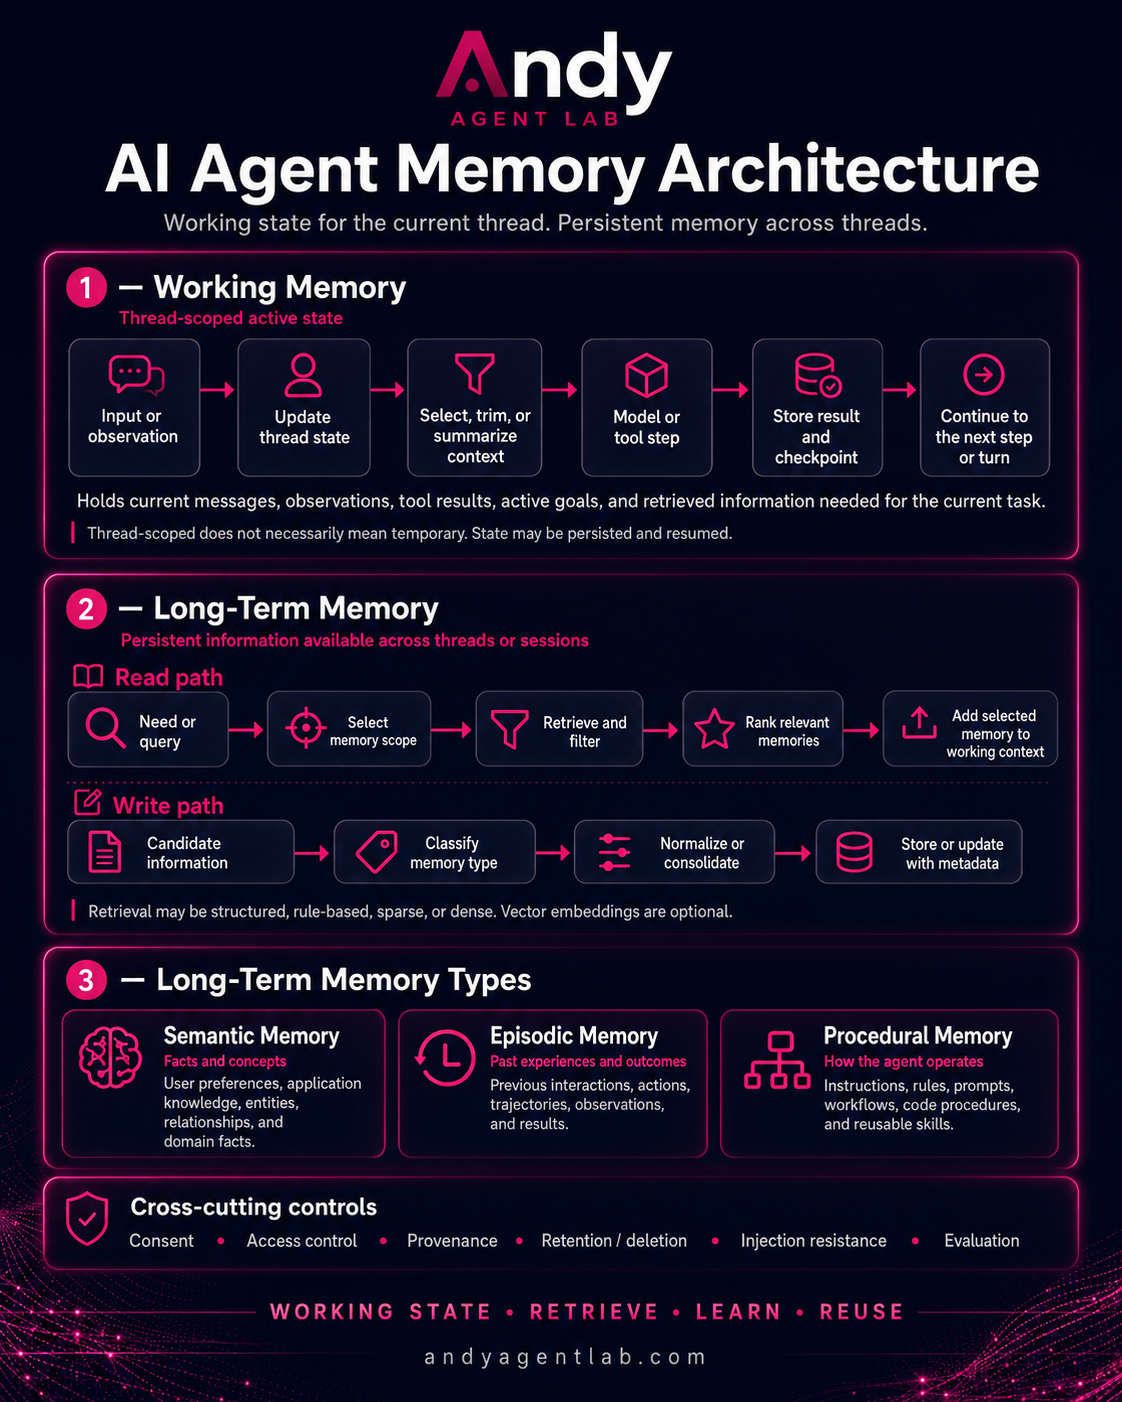
图:线程作用域的工作状态与持久记忆读写路径的高层运行视图。语义、情景与程序性记忆是长期记忆内部的功能角色;表示形式与存储/访问介质是下文将分析的独立维度。
维度一:时间范围
这一维度描述信息在何时处于活跃状态、或可供复用。
- 工作状态(working state):包含当前任务或决策过程中活跃的信息。它可能在同一任务内的多次模型调用之间持续存在。
- 持久记忆(persistent memory):包含保留在活跃工作状态之外的信息,以便在后续的任务周期、会话或交互中被检索或重新激活。
维度二:功能角色
这一维度描述信息代表什么,或它如何影响行为。
- 情景记忆(episodic memory):表示事件、交互、轨迹(trajectory)与结果。
- 语义记忆(semantic memory):表示事实、概念、实体、属性与关系。
- 程序性记忆(procedural memory):表示规则、技能、策略、工作流或行动策略。
在 CoALA 框架中,情景、语义与程序性记忆是长期记忆内部的类别,而不是与长期记忆本身平级的概念[1]。当信息从这些记忆组件中被检索或重新激活时,被选中的表示就成为活跃工作状态的一部分,或变得对负责当前任务的控制器(controller)可用。
维度三:表示形式
这一维度描述信息以何种形式被编码。
- 参数化表示(parametric representation):把信息编码为模型参数中的分布式模式。
- 文本表示(textual representation):把信息编码为消息、文档、笔记、摘要或其他文本。
- 结构化表示(structured representation):把信息编码为带类型的记录、实体、属性或关系。
- 向量表示(vector representation):把信息编码为用于相似性运算的嵌入(embedding)。
- 图表示(graph representation):把信息编码为节点、边与带类型的关系。
- 可执行表示(executable representation):把过程编码为代码、规则、提示词、策略或工作流定义。
维度四:存储与访问介质
这一维度描述表示存放在哪里,系统如何寻址或检索它。
可能的介质包括:
- 当前的模型上下文;
- 模型参数;
- 关系或键值数据库;
- 文档存储;
- 事件存储;
- 搜索索引;
- 向量索引;
- 图存储(graph store);
- 文件系统;
- 代码或配置仓库。
这些维度应当分开分析,尽管它们在实现中相互交织。一条用户偏好可以是:时间范围上持久、功能上语义、表示上结构化、存放在关系数据库中;一条完整的工具轨迹可以是:情景性的、表示为结构化事件、存放在事件存储中;一条可复用工作流可以是:程序性的、表示为可执行配置、存放在代码仓库中。
因此,同一种功能类型的记忆,可以通过多种表示形式与存储/访问介质来实现。
工作状态:当前活跃的信息
工作状态是当前可供模型或控制器用于活跃任务的信息。取决于架构,它可能包括:
- 系统与开发者指令;
- 当前的用户请求;
- 被选中的对话历史;
- 活跃目标与任务状态;
- 检索到的记忆记录;
- 工具结果与观察;
- 中间计划或结构化状态;
- 应用施加的约束。
上下文窗口是单次模型调用可用的、模型一侧的词元容量。Anthropic 把上下文窗口描述为模型生成回复时可引用的文本,并以“工作记忆(working memory)”作为操作性类比[8]。OpenAI 则另行记录了跨回复携带对话状态的机制,包括持久的会话对象(persistent conversation object)与响应链式衔接(response chaining)[6]。
这些描述支撑起一个重要的架构区分:上下文窗口限制的是单次模型调用可用的词元化材料;而工作状态是更广泛的系统状态,模型面对的上下文正是从中选择并组装出来的。工作状态可以横跨一个任务内的多次模型调用,还可能包含控制器状态或工具可访问的信息——这些信息并不逐字放入模型输入。
对话历史可以构成工作状态的一部分,但二者并不等同。系统可以剔除旧轮次、只检索被选中的片段、注入结构化的应用状态,或从外部记录重建当前的模型上下文。反过来,一份记录也可能被保存在存储中,却并未加载进当前的调用。
持久记忆:留存以备未来使用的信息
持久记忆是超出当前模型调用或活跃任务状态而被保留的信息。它的持久化期限可以是一个工作流、一次用户会话、多个会话、一个项目、一个组织,乃至系统的整个生命周期。
持久化并不意味着持续存在于上下文窗口中。在多数可扩展架构中,持久信息保持在活跃上下文之外,直到某条检索规则或应用规则选中它。由此产生三个相互独立的问题:
- 信息被存储了吗?
- 它为当前任务被检索了吗?
- 模型或控制器正确使用它了吗?
这三个问题对应着不同的失败模式。一条正确的记录可以存在,却始终未被发现;一条相关记录可以被检索出来,却在排序时被排到不相关材料之后;一条被选中的记录可以进入上下文,却仍被误读或忽略。
持久的对话状态是一种可能的实现。它可以在会话之间保留先前的消息与工具交互,但它本身并不定义语义结构、检索标准、冲突消解、留存规则或记忆评估。它是状态连续性机制,而不是完整的记忆架构。
情景记忆:事件、交互与结果
情景记忆表示有时间定位的经验。在代理系统中,一个情景(episode)可以描述一次对话、一次任务尝试、一条工具使用轨迹、一个决策、一个被观察到的事件,或一个结果。
一条有用的情景记录可能包含:
- 事件或任务标识;
- 时间戳或时间范围;
- 参与的参与者或系统;
- 相关上下文;
- 观察;
- 采取的行动;
- 结果;
- 来源或溯源(provenance);
- 评估、反馈或奖励信号。
其决定性属性并不是存储模式(schema),而是信息与某个具体事件或经验之间的联系。
Generative Agents(生成式代理)研究提供了一个具体实例。其架构把观察写入一个记忆流(memory stream),按近因性(recency)、重要性(importance)与相关性(relevance)检索记录,并生成能够影响后续规划的更高层反思(reflection)[5]。这是一种实现模式,而非普适的设计要求。它说明情景记忆不止是保留对话记录:系统还需要一种方法,来决定过去的哪些经验与当前状态相关。
语义记忆:事实、概念与关系
语义记忆表示并非主要由单一被记住的事件来定义的信息。典型例子包括:
- 用户或系统属性;
- 稳定的偏好;
- 关于实体的事实;
- 领域概念;
- 记录之间的关系;
- 跨任务仍然适用的约束。
一条情景记录与一条语义记录可以在不同层级上指向同一底层信息。例如,“用户在 7 月 10 日的评审期间选择了选项 B”是情景性的;“用户对这个项目偏好选项 B”则只有在系统具备提取并维护该偏好的合理规则时,才是语义性的。
这一区分之所以重要,是因为事件存储不会自动产生可靠的语义知识。把反复出现的情景转化为一条泛化的事实,是一种整合(consolidation)操作;它可能需要证据阈值、冲突处理、时间限定或明确确认。
语义记忆也不应被描述为“系统所理解的意义”。这种措辞所隐含的宣称,比架构实际所需的更强。系统需要的是一种能够支撑后续检索与计算的表示;这一定义并不依赖于赋予系统类人的理解。
程序性记忆:规则、技能与行动方式
程序性记忆表示支配代理如何执行任务或选择行动的信息。它可以表现为:
- 工作流定义;
- 工具使用过程;
- 决策规则;
- 规划策略;
- 指导行为的提示词或策略(policy);
- 可执行代码;
- 编码在模型参数中的习得行动模式。
程序性记忆比一份固定的顺序步骤清单更宽泛。一个过程可以包含分支、前置条件、异常处理、循环、工具选择规则,或把状态映射到行动的策略。
过程本身还必须与其执行相区分。“调用工具 A、校验结果、再选择工具 B 或 C”可以是程序性记忆;该过程的一次具体运行(包括其输入与结果)则是一个情景。二者可以相互关联,但并不是同一条记录。
CoALA 明确把程序性记忆视为长期记忆组件,它可以既包含 LLM 中的隐性知识,也包含周围代理系统中的显式代码或策略[1]。这在生产架构中尤为重要——行为常常分散在模型参数、提示词、工作流定义与控制器逻辑之间。
参数记忆与外部记忆在表示与更新属性上有所不同
最初的 RAG 论文区分了参数记忆(parametric memory)与非参数记忆(non-parametric memory)。在该架构中,参数组件是一个预训练的序列到序列(sequence-to-sequence)模型,非参数组件则是一个通过神经检索器访问的维基百科稠密向量索引[2]。
该架构演示了一种把编码在模型参数中的信息、与从外部系统检索到的信息结合起来的途径。它并不能推出“所有外部记忆都必须使用嵌入或向量数据库”。
外部记忆可以用以下方式实现:
- 关系表;
- 文档集合;
- 事件流;
- 键值存储;
- 搜索索引;
- 向量索引;
- 知识图谱;
- 文件系统;
- 代码或规则仓库。
向量嵌入是用于相似性运算的一种表示;向量索引是支撑在这些表示之上进行检索的一种访问结构。二者本身都不是完整的记忆架构。生产级记忆设计仍然需要关于写入、范围界定、校验、更新、删除、检索、排序与使用记录的策略。
参数记忆的运行属性不同。编码在模型参数中的信息是分布式(distributed)的,并不以常规应用记录的形式暴露出来,因此通常无法用数据库记录那套机制去检查、版本化、更新或删除它。训练、微调(fine-tuning)、模型编辑(model editing)与外部记忆写入,应当被当作操作不同、控制方式不同、失败模式也不同的独立操作来处理。
记忆生命周期
没有任何单一生命周期是所有代理系统的标准。不过,文献支持在存储、检索与下游使用之间做出明确划分。例如,LongMemEval 就把长期记忆设计拆解为索引、检索与读取三个阶段[4]。更完整的工程生命周期,可以让其余决策显式化。
1. 捕获
系统观察到某个输入、事件、工具结果、任务结果或状态变化——它以后可能有用。
捕获并不等于持久化。原始观察可能是瞬时的、重复的、不完整的,或者与未来任务无关。
2. 写入选择
写入策略(write policy)决定信息是否应当成为持久记忆。
该决策可能考虑:
- 预期的未来效用;
- 记录类型;
- 范围(scope);
- 重复情况;
- 时间相关性;
- 来源质量;
- 要求的留存期限;
- 是否应当改为更新一条既有记录。
一个把每条消息或工具结果都写入的系统,拥有的是历史存储,而不一定是可用的记忆系统。无界累积会增加检索噪声,使过时或矛盾的记录更难管理。
3. 表示
被选中的信息被转换为适合其功能与未来访问路径的表示。这可以是:
- 原始事件;
- 结构化记录;
- 规范化后的实体或关系;
- 摘要;
- 嵌入向量;
- 过程;
- 对模型参数的一次更新。
表示并不是中性的。摘要可能丢失细节;实体抽取可能引入错误;从若干情景中推断出的语义事实可能过度泛化。因此,架构应当区分源记录(source record)与派生记录(derived record)。
4. 校验与溯源
在持久化前后,系统可以校验记录并附上如下元数据:
- 来源;
- 创建时间;
- 生效时间(effective time);
- 范围;
- 版本;
- 置信度或状态;
- 与更早记录的关系。
这类元数据没有通用模式。架构层面的要求是:系统保留足够的信息,以便正确地解释与更新记录。
5. 存储与索引
存储保存记录;索引建立一条或多条找到它的路径。
这是两个独立操作。一条记录可以存储在数据库中,并按实体标识、时间、关键词、图关系、嵌入向量或同时按其中若干信号建立索引。相似性搜索只是众多检索方法中的一种。
6. 检索与排序
在后续任务中,系统生成候选记录并按其相关性排序。检索可以使用:
- 实体标识;
- 词法匹配;
- 语义相似性;
- 时间约束;
- 近因性;
- 重要性;
- 任务类型;
- 记录状态;
- 结构化与非结构化信号的组合。
检索质量取决于查询、索引、元数据、排序函数,以及已存储表示的完整程度。相关记录存在,并不保证系统会检索到它。
7. 上下文组装与读取
被选中的记录被插入工作状态,或通过工具暴露出来。模型或控制器随后必须结合当前任务来解释它们。
这一阶段区别于检索。LongMemEval 之所以把检索与读取分开,是因为系统可以呈现正确的证据,却仍然答错[4]。长上下文研究也印证了同一点:信息可以出现在输入中,却不被稳健地使用[3]。
8. 使用
活跃系统使用被选中的信息来生成回复、继续任务、选择行动、个性化行为,或解决当前的某个决策。
记忆的效果应当在任务层面可观察。一条被存储又被检索、却没有改变相关决策的记录,对该任务并未提供操作层面的价值。
9. 更新与整合
新的观察可能确认、细化、反驳或取代既有记录。架构需要为以下行为定义明确的策略:
- 替换过时的值;
- 保留时间历史;
- 合并重复项;
- 保留相互冲突的主张;
- 从反复出现的情景中派生出语义记录;
- 在评估结果之后修订某个过程。
更新逻辑是记忆模型的一部分。只追加新记录、却不定义它与既有记录的关系,可能让系统对同一事实同时保留多个互不兼容的版本。
10. 过期与删除
有些记录应当停止影响未来的行为。系统可以按时间、范围、状态、显式移除或领域特定的留存规则,让记录过期。
删除不等于把一条记录排除在某次提示词之外。完整的设计必须明确:当一条记忆被移除或失效时,哪些表示、索引、摘要与派生记录会受到影响。
参考流程图
生命周期可以表示为一个系统流程图,而不是五个并行的“记忆层”:
当前输入 ─────────────────────────┐指令 ─────────────────────────────┤工具结果 ─────────────────────────┤应用任务状态 ─────────────────────┤检索到的记忆记录 ─────────────────┤ ▼ 工作状态 │ │ 选定的词元化材料 ▼ 模型上下文 │ ▼ 推理 / 决策 / 行动 │ ▼ 结果与反馈 │ ▼ 捕获 → 选择 → 表示 → 校验 │ ▼ 存储并创建索引 │ ▼ 持久记忆记录 ├─ 情景记忆 ├─ 语义记忆 └─ 程序性记忆 │ ▼ 检索 → 排序 → 选择 │ └──────────────► 检索到的记忆记录
存储与访问实现:模型参数 · 数据库 · 文档 · 事件存储搜索索引 · 向量索引 · 图存储文件系统 · 代码仓库
横切操作:更新 · 整合 · 取代 · 过期 · 删除该图把常被合并的五个问题区分开来:
- 当前工作状态中,哪些信息是活跃的?
- 哪些信息在该活跃状态之外持续存在?
- 每条记忆记录承担什么功能角色?
- 信息如何被表示、存储与访问?
- 哪些操作把留存的信息连接到未来的行为?
长上下文不等于长期记忆
更大的上下文窗口提高的,是单次调用能够提供给模型的信息量。它并不会凭空产生持久的记忆生命周期。
这一区分既是概念上的,也是经验上的。Lost in the Middle(迷失在中间)研究发现,相关信息在长输入中的位置会显著改变模型表现:相关证据出现在开头或结尾附近时,表现通常最强;出现在中间时则较弱[3]。这一结果表明,信息出现在上下文之内,并不保证会被稳健地使用。
因此,长上下文系统仍然需要选择与组织。把整份对话记录原样传入,可能既消耗容量,又让关键证据更难被识别。对许多任务而言,一份更小但构造良好的工作状态,可能比一份不加区分地更大的状态更有用。
对话状态与压缩是上下文管理机制
对话状态 API 可以跨轮次保存消息、工具调用、工具输出及其他条目。例如,OpenAI 记录了持久的会话对象与响应链式衔接,把它们作为跨响应共享上下文的机制[6]。这种连续性可以支撑依赖记忆的应用,但它并不决定哪些内容应当被保留为持久的语义、情景或程序性记忆。
压缩(compaction)解决的是另一个问题:当累积的上下文接近模型上限时,如何继续一段很长的交互。OpenAI 记录了压缩条目(compaction item),用更少的词元把选中的先前状态带向前[7]。Anthropic 记录了服务端压缩,通过总结更早的对话内容使交互得以继续[8]。
因此,被压缩的状态应当被当作一种派生的上下文表示,而不是自动地当作权威的记忆存储。当精确的历史、溯源或可逆的更新很重要时,源记录与被压缩的表示各司其职。
记忆失败发生在不同阶段
把记忆当作生命周期来对待,能让诊断更精确。
写入失败
系统没有存储本应持久化的信息,或者存储了对源事件的错误解读。
表示失败
存储的记录丢失了必要的细节、编码了错误的实体或时间,或者把一条有条件的观察变成了无条件的事实。
检索失败
相关记录存在,但未针对当前任务被返回。
排序失败
正确记录被检索出来了,却被更不相关或过时的记录挤掉。
读取失败
正确的证据就在工作状态中,但模型或控制器错误地解释了它,或没能使用它。
更新失败
新记录没有取代旧记录,或者相互冲突的记录在缺乏时间或状态信息的情况下悬而未决。
时间性失败
系统记住了内容,却把它应用到了错误的时间段,或未能对先后顺序与变化进行推理。
弃答失败
所需信息并不存在,系统却表现得像有记忆支撑一样作答。
LongMemEval 直接评估了信息抽取、多会话推理、时间推理、知识更新与弃答(abstention)[4]。这些类别说明了,为什么单一的“检索召回率”分数不足以评估端到端的记忆行为。
必须明确的架构决策
专业的记忆架构,应当先于数据库或检索框架的选择,界定以下决策。
| 决策 | 必须回答的问题 |
|---|---|
| 写入策略 | 哪些观察会成为持久记录,哪些保持瞬时? |
| 记忆类型 | 该记录是情景、语义、程序性的,还是通过关联记录表示的某种组合? |
| 范围 | 该记录适用于一个任务、会话、用户、项目、租户,还是整个系统? |
| 粒度 | 源信息被保存为完整事件、结构化事实、摘要,还是若干相互关联的表示? |
| 存储模型 | 哪种介质支撑所需的查询、更新、溯源与留存行为? |
| 索引 | 需要哪些访问路径:标识、时间、文本、嵌入、图关系,还是混合索引? |
| 检索触发 | 记忆检索应在何时发生?以什么构成查询? |
| 排序与选择 | 在上下文预算内,相关性、近因性、状态与任务契合度如何组合? |
| 冲突处理 | 相互矛盾、重复或被取代的记录如何表示? |
| 整合 | 情景何时可以产生或修订语义知识或过程? |
| 过期与删除 | 记录何时应停止影响行为?哪些派生表示也必须随之改变? |
| 评估 | 系统如何测试存储、检索、读取、时间正确性、更新与弃答? |
这些决策在逻辑上先于实现。先选一个向量数据库,只回答了存储与索引问题的一部分。
评估代理记忆系统
记忆评估应当把组件性能与端到端任务性能分开。
组件级评估
工程指标可能包括:
- 写入准确率;
- 重复率与矛盾率;
- 检索召回率与精确率;
- 排序质量;
- 记录新鲜度;
- 检索延迟;
- 存储增长;
- 上下文词元成本;
- 溯源保留情况。
这些指标能定位流水线在哪里失败,但不能证明代理正确地使用了记忆。
端到端评估
LongMemEval 通过测试五种能力,提供了一个更强的行为框架[4]:
- 信息抽取;
- 多会话推理;
- 时间推理;
- 知识更新;
- 在所需信息不可用时弃答。
完整的评估还应当测试:记录相互冲突时、相关证据与干扰项混杂时、以及某条已存储内容不再有效时,系统是否行为正确。基准设计应当匹配预期的记忆范围,而不是假设通用的对话式回忆对每个代理都足够。
关键区分在于:
检索成功不等于记忆成功。
只有当正确的信息被留存、检索、解读,并应用到正确的任务与时间时,系统才算成功。
常见的范畴错误
上下文窗口 = 记忆
上下文窗口是有界的模型输入容量。它可以容纳工作状态,但它并不定义持久化、检索、更新或删除。
对话历史 = 记忆架构
一份记录只是情景记录的一种可能来源。没有选择、结构、检索与更新规则,它就仍然是历史,而不是完整的记忆系统。
RAG = 长期记忆
RAG 是一族检索增强生成架构。它可以提供对外部信息的访问,但它本身并不定义记忆写入、时间性更新、整合或留存。
向量数据库 = 记忆
向量数据库支撑的是一种存储与相似性检索模式。它并不决定哪些记录应当存在、它们意味着什么、如何变化,或代理应当如何使用它们。
检索 = 使用
一条被检索出来的记录可能被忽略、误读,或被其他上下文压过。检索与读取必须分开评估。
过程执行 = 程序性记忆
程序性记忆描述的是可复用的规则、技能或策略。某一次具体的执行及其结果,是情景记录。
存储一切 = 学习
持久化不等于学习。只有当被存储或更新的信息,通过既定的访问与使用机制改变了未来行为时,系统才在操作意义上学会了。
持久化 = 相关性
一条记录在过时、被取代或变得不相关之后,仍可能留在存储中。留存与选择是两种不同的策略。
结论
LLM 代理中的记忆架构,最好被理解为一套协同运作的信息系统,而不是单一的存储,也不是固定的一摞分层。
工作状态与持久记忆描述的是时间上的可用性;情景、语义与程序性记忆描述的是功能角色;参数化、文本、结构化、向量、图与可执行表示,描述的是实现介质(substrate)。完整的架构通过显式的写入、检索、选择、更新、整合与删除操作,把这些维度连接起来。
这个模型也厘清了记忆不是什么。它并不等同于上下文窗口、对话记录、向量数据库或 RAG。其中每一者都可以参与记忆系统,但没有哪一个能提供完整的生命周期。
因此,实用的标准不在于代理能否宣称自己“记得”。而在于系统能否解释、测试并控制:
- 什么被留存了;
- 它如何被表示;
- 它为何被检索;
- 它是否被正确使用;
- 当更新的信息到来时它如何变化;
- 以及它应在何时停止影响未来的行为。
延伸阅读
接着读与运行机制、边界、来源覆盖和控制面最接近的主题。
- 指南:How to Control AI Memory and Context Sources:区分当前的提示词、文件、已保存记忆、先前的对话、项目上下文、检索、已连接的应用与后端状态。
- 架构文章:LLM Memory vs. Context: 5 Architecture Boundaries:追踪存储状态如何跨越调用、持久化、检索、上下文组装与更新等边界。
- 文章:AI File Upload vs. Full-File Review: How to Verify Coverage:理解在基于文档的 AI 工作流中,文件可用性、检索、活跃上下文与来源覆盖之间的差异。
- 文章:LLM-Led vs Orchestrator-Led Tool Execution:比较执行权、状态迁移、工具选择与策略强制应当归属在代理架构中的哪个位置。
参考文献
- Sumers TR, Yao S, Narasimhan K, Griffiths TL. Cognitive Architectures for Language Agents. Transactions on Machine Learning Research. 2024.
- Lewis P, Perez E, Piktus A, et al. Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks. Advances in Neural Information Processing Systems 33. 2020.
- Liu NF, Lin K, Hewitt J, et al. Lost in the Middle: How Language Models Use Long Contexts. Transactions of the Association for Computational Linguistics. 2024;12:157–173. DOI: 10.1162/tacl_a_00638.
- Wu D, Wang H, Yu W, Zhang Y, Chang K-W, Yu D. LongMemEval: Benchmarking Chat Assistants on Long-Term Interactive Memory. International Conference on Learning Representations. 2025.
- Park JS, O’Brien JC, Cai CJ, Morris MR, Liang P, Bernstein MS. Generative Agents: Interactive Simulacra of Human Behavior. Proceedings of the 36th Annual ACM Symposium on User Interface Software and Technology. 2023. DOI: 10.1145/3586183.3606763.
- OpenAI. Conversation State — OpenAI API Documentation.
- OpenAI. Compaction — OpenAI API Documentation.
- Anthropic. Context Windows — Claude Platform Documentation.